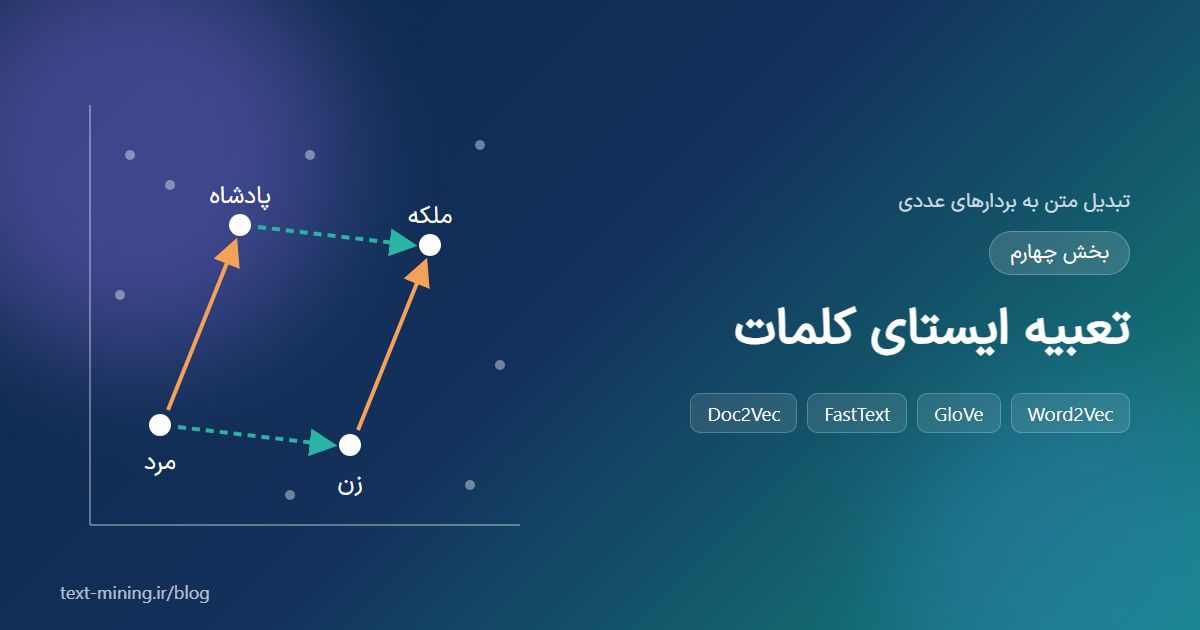
روشهای کیف کلمات و مدلهای موضوعی بردار اسناد را میسازند، اما درکی از معنای تکتک کلمات ندارند. در سال ۲۰۱۳ با معرفی Word2Vec، رویکرد جدیدی به نام تعبیه کلمات (Word Embedding) فراگیر شد که برای هر کلمه یک بردار چگال و کمبُعد (معمولاً ۱۰۰ تا ۳۰۰ بُعد) یاد میگیرد؛ بهگونهای که کلمات هممعنا بردارهای نزدیک به هم داشته باشند و حتی روابط معنایی (مانند جنسیت یا پایتخت بودن) بهصورت جهتهایی در فضای برداری ظاهر شوند.
فرضیه توزیعی و بازنمایی توزیعشده
پایه نظری همه روشهای این بخش فرضیه توزیعی (Distributional Hypothesis) است که زبانشناس انگلیسی، جان فرث، آن را اینگونه خلاصه کرد: «معنای یک کلمه را از همنشینهایش میشناسیم». برای مثال، کلمات «کتاب» و «مجله» هر دو در کنار کلماتی مانند «خواندن»، «صفحه» و «نویسنده» به کار میروند؛ پس احتمالاً معنای نزدیکی دارند.
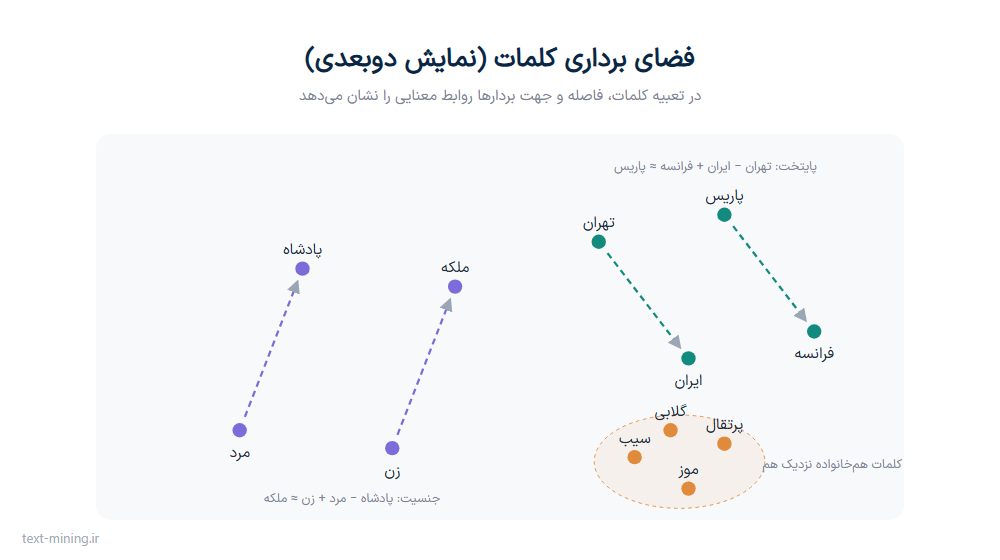
در بازنمایی توزیعشده (Distributed Representation)، برخلاف بردار وانهات که هر کلمه را با یک خانه نشان میدهد، معنای هر کلمه در میان همه ابعاد بردار «توزیع» میشود. نتیجه، فضایی است که در آن عملیات برداری معنادار است:
۱. Word2Vec
Word2Vec که توسط میکولوف و همکارانش در گوگل معرفی شد، یک شبکه عصبی کمعمق (با یک لایه پنهان) است که با یک وظیفه ساده پیشبینی آموزش میبیند. پس از آموزش، وزنهای لایه پنهان همان بردارهای کلمات هستند. Word2Vec دو معماری دارد:
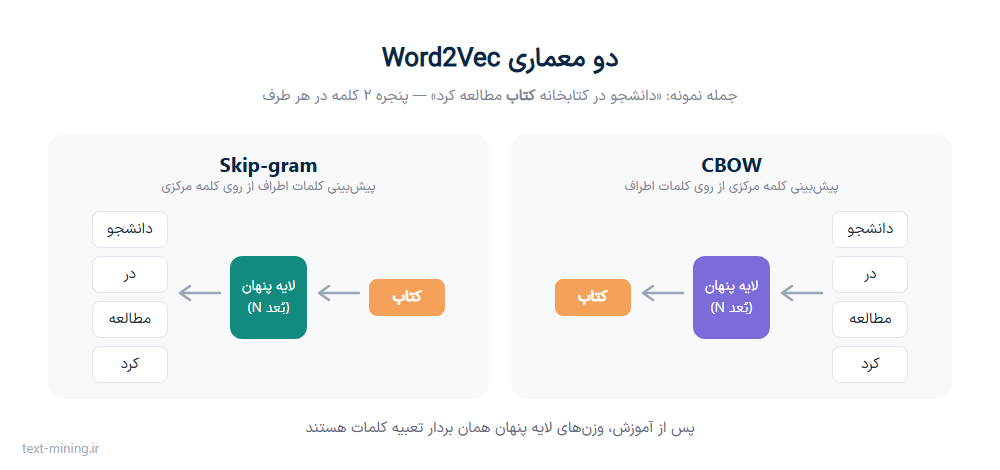
- CBOW (Continuous Bag-of-Words): کلمه مرکزی را از روی میانگین بردار کلمات اطراف آن پیشبینی میکند. سریعتر است و برای کلمات پرتکرار عملکرد خوبی دارد.
- Skip-gram: کلمات اطراف را از روی کلمه مرکزی پیشبینی میکند. کندتر است اما برای کلمات کمتکرار و پیکرههای کوچکتر بهتر عمل میکند.
برای کارایی، بهجای محاسبه softmax روی کل واژگان از ترفندهایی مانند نمونهبرداری منفی (Negative Sampling) و softmax سلسلهمراتبی استفاده میشود. پیادهسازی استاندارد در پایتون، کتابخانه gensim است:
pip install gensim hazm fasttext-wheel torchfrom gensim.models import Word2Vec
from hazm import Normalizer, sent_tokenize, word_tokenize
normalizer = Normalizer()
# raw_texts: لیستی از متون خام فارسی (هرچه پیکره بزرگتر، بردارها بهتر)
sentences = [
word_tokenize(sent)
for text in raw_texts
for sent in sent_tokenize(normalizer.normalize(text))
]
model = Word2Vec(
sentences,
vector_size=200, # ابعاد بردار
window=5, # اندازه پنجره بافت
min_count=5, # حذف کلمات کمتکرار
sg=1, # 1 = Skip-gram و 0 = CBOW
negative=10, # نمونهبرداری منفی
workers=4,
epochs=10,
)
print(model.wv["کتاب"].shape) # (200,)
print(model.wv.most_similar("کتاب", topn=5)) # کلمات مشابه
print(model.wv.similarity("خودرو", "ماشین")) # شباهت کسینوسی
# قیاس معنایی: پادشاه - مرد + زن ≈ ملکه
print(model.wv.most_similar(positive=["پادشاه", "زن"], negative=["مرد"], topn=3))
model.save("word2vec_fa.model") # برای بارگذاری از Word2Vec.load استفاده کنیدکیفیت بردارها به شدت به حجم و کیفیت پیکره وابسته است. برای آموزش بردارهای فارسی میتوانید از پیکرههایی مانند پیکره ویکیپدیای فارسی یا پیکره اخبار فارسییار استفاده کنید.
از بردار کلمه به بردار سند
سادهترین راه برای ساخت بردار یک جمله یا سند، میانگینگیری از بردار کلمات آن است. این روش با وجود سادگی، در بسیاری از کاربردها (بهویژه با وزندهی TF-IDF روی میانگین) نتایج قابل قبولی دارد:
import numpy as np
from hazm import word_tokenize

def document_vector(text, wv):
    words = [w for w in word_tokenize(text) if w in wv]
    if not words:
        return np.zeros(wv.vector_size)
    return np.mean([wv[w] for w in words], axis=0)

vec = document_vector("پردازش متن فارسی جذاب است", model.wv)
۲. GloVe
GloVe (Global Vectors) که در سال ۲۰۱۴ در دانشگاه استنفورد معرفی شد، دو دیدگاه را با هم ترکیب میکند: آمار سراسری همرخدادی کلمات (مانند LSA) و یادگیری بردار با پنجره بافت محلی (مانند Word2Vec). GloVe ابتدا ماتریس همرخدادی کلمه-کلمه را از کل پیکره میسازد و سپس بردارها را طوری یاد میگیرد که ضرب داخلی دو بردار، لگاریتم احتمال همرخدادی آن دو کلمه را تقریب بزند.
بردارهای از پیش آموزشدیده GloVe عمدتاً برای زبان انگلیسی منتشر شدهاند و با gensim بهراحتی قابل استفادهاند. برای آموزش GloVe روی پیکره فارسی میتوان از پیادهسازی رسمی استنفورد استفاده کرد.
import gensim.downloader as api

glove = api.load("glove-wiki-gigaword-100")    # بردارهای 100 بعدی انگلیسی
print(glove.most_similar("computer", topn=5))
print(glove.most_similar(positive=["king", "woman"], negative=["man"], topn=1))
۳. FastText
یکی از مهمترین ضعفهای Word2Vec و GloVe این است که برای کلمات خارج از واژگان (Out-of-Vocabulary – OOV) هیچ برداری ندارند و ساختار درونی کلمات را نادیده میگیرند. FastText که در سال ۲۰۱۶ توسط فیسبوک معرفی شد، هر کلمه را بهصورت مجموعهای از چندگانههای حرفی (مثلاً ۳ تا ۶ حرفی) در نظر میگیرد و بردار کلمه را جمع بردار این زیرکلمهها میسازد. برای مثال کلمه «کتابخانه» شامل زیرکلمههایی مانند «کتا»، «تاب»، «خانه» و … است.
این ویژگی FastText را به گزینهای بسیار مناسب برای زبان فارسی تبدیل میکند که در آن پیشوندها و پسوندها (مانند «ها»، «ترین»، «می» و ضمایر متصل)، کلمات مرکب و املاهای متفاوت فراواناند:
from gensim.models import FastText
ft = FastText(sentences, vector_size=200, window=5, min_count=3, min_n=3, max_n=6, epochs=10)
# حتی کلمهای که در پیکره آموزش نبوده، بردار دارد
print(ft.wv["کتابخانههایمان"].shape)
print(ft.wv.most_similar("کتابخانههایمان", topn=5))فیسبوک بردارهای از پیش آموزشدیده FastText را برای ۱۵۷ زبان (از جمله فارسی) روی ویکیپدیا و Common Crawl منتشر کرده است که بدون نیاز به آموزش قابل استفادهاند:
import fasttext
import fasttext.util
fasttext.util.download_model("fa", if_exists="ignore") # دریافت cc.fa.300.bin (حدود 7 گیگابایت)
ft_fa = fasttext.load_model("cc.fa.300.bin")
print(ft_fa.get_word_vector("دانشگاه").shape) # (300,)
print(ft_fa.get_nearest_neighbors("دانشگاه", k=5))
print(ft_fa.get_sentence_vector("متن کاوی فارسی").shape) # بردار جمله
fasttext.util.reduce_model(ft_fa, 100) # کاهش ابعاد به 100 برای صرفهجویی در حافظهعلاوه بر بردار کلمات، کتابخانه fasttext یک دستهبند متن بسیار سریع (fasttext.train_supervised) نیز دارد که برای دستهبندی حجم زیاد متون، خط مبنای خوبی است.
۴. Doc2Vec (Paragraph Vector)
Doc2Vec که در سال ۲۰۱۴ توسط لی و میکولوف معرفی شد، تعمیم Word2Vec برای یادگیری مستقیم بردار جملات، پاراگرافها و اسناد است. در این روش، علاوه بر بردار کلمات، برای هر سند نیز یک بردار (شناسه سند) در نظر گرفته و همراه با کلمات بافت آموزش داده میشود. دو نسخه دارد: PV-DM (مشابه CBOW) و PV-DBOW (مشابه Skip-gram). برای اسناد جدید، بردار با چند مرحله بهینهسازی «استنتاج» میشود:
from gensim.models.doc2vec import Doc2Vec, TaggedDocument
from hazm import word_tokenize

tagged = [TaggedDocument(words=word_tokenize(d), tags=[i]) for i, d in enumerate(docs)]

d2v = Doc2Vec(tagged, vector_size=100, window=5, min_count=2, dm=1, epochs=40, workers=4)

new_vec = d2v.infer_vector(word_tokenize("بازار بورس امروز رشد کرد"))
print(d2v.dv.most_similar([new_vec], topn=3))   # شناسه 3 سند مشابه
۵. لایه تعبیه (Embedding Layer) در شبکههای عصبی
در مدلهای یادگیری عمیق، معمولاً اولین لایه شبکه یک لایه تعبیه است: یک جدول جستجو (ماتریس) به ابعاد «تعداد واژگان × ابعاد بردار» که شماره هر کلمه را به بردار آن تبدیل میکند. این لایه میتواند بهصورت تصادفی مقداردهی و همراه با کل شبکه برای یک وظیفه خاص (مانند تحلیل احساسات) آموزش داده شود، یا با بردارهای از پیش آموزشدیده (Word2Vec یا FastText) مقداردهی شود:
import torch
import torch.nn as nn
class TextClassifier(nn.Module):
def __init__(self, vocab_size, embed_dim, num_classes, pretrained=None):
super().__init__()
self.embedding = nn.EmbeddingBag(vocab_size, embed_dim, mode="mean")
if pretrained is not None: # ماتریس بردارهای از پیش آموزشدیده (vocab_size × embed_dim)
self.embedding.weight.data.copy_(torch.as_tensor(pretrained))
self.fc = nn.Linear(embed_dim, num_classes)
def forward(self, token_ids, offsets):
return self.fc(self.embedding(token_ids, offsets))
model = TextClassifier(vocab_size=50000, embed_dim=300, num_classes=3)محدودیت تعبیههای ایستا
با وجود پیشرفت چشمگیر، همه روشهای این بخش یک محدودیت بنیادین دارند: برای هر کلمه فقط یک بردار ثابت (ایستا) تولید میکنند. بنابراین کلمه «شیر» در «شیر جنگل»، «لیوان شیر» و «شیر آب» بردار یکسانی دارد که میانگینی از همه معانی آن است. همچنین ترتیب کلمات و ساختار جمله در بردار سند (میانگین بردارها) از دست میرود.
| روش | سال | ایده اصلی | کلمات خارج از واژگان | نقطه قوت |
|---|---|---|---|---|
| Word2Vec | ۲۰۱۳ | پیشبینی بافت محلی | پشتیبانی نمیکند | سریع، قیاسهای معنایی |
| GloVe | ۲۰۱۴ | تجزیه آمار همرخدادی سراسری | پشتیبانی نمیکند | بهرهگیری از آمار کل پیکره |
| FastText | ۲۰۱۶ | چندگانههای حرفی | پشتیبانی میکند | زبانهای با ریختشناسی غنی مانند فارسی |
| Doc2Vec | ۲۰۱۴ | بردار مستقل برای هر سند | با استنتاج | بردار مستقیم سند |
حل این محدودیت، یعنی تولید بردار وابسته به بافت برای هر کلمه، موضوع بخش پنجم است که در آن با ELMo، ترنسفورمرها و BERT آشنا میشویم.
منابع
- Mikolov, T., Chen, K., Corrado, G., & Dean, J. (2013). Efficient Estimation of Word Representations in Vector Space. arXiv:1301.3781
- Mikolov, T., Sutskever, I., Chen, K., Corrado, G., & Dean, J. (2013). Distributed Representations of Words and Phrases and their Compositionality. NeurIPS. arXiv:1310.4546
- Pennington, J., Socher, R., & Manning, C. D. (2014). GloVe: Global Vectors for Word Representation. EMNLP. aclanthology.org/D14-1162
- Bojanowski, P., Grave, E., Joulin, A., & Mikolov, T. (2017). Enriching Word Vectors with Subword Information. TACL. arXiv:1607.04606
- Grave, E., Bojanowski, P., Gupta, P., Joulin, A., & Mikolov, T. (2018). Learning Word Vectors for 157 Languages. LREC. arXiv:1802.06893
- Le, Q., & Mikolov, T. (2014). Distributed Representations of Sentences and Documents. ICML. arXiv:1405.4053
- Firth, J. R. (1957). A synopsis of linguistic theory 1930–1955. Studies in Linguistic Analysis.
- مستندات gensim: models.word2vec و models.fasttext
- بردارهای از پیش آموزشدیده FastText: fasttext.cc/docs/en/crawl-vectors
استفاده از این مقاله با ذکر منبع «سامانه متن کاوی فارسییار – text-mining.ir»، بلامانع است.