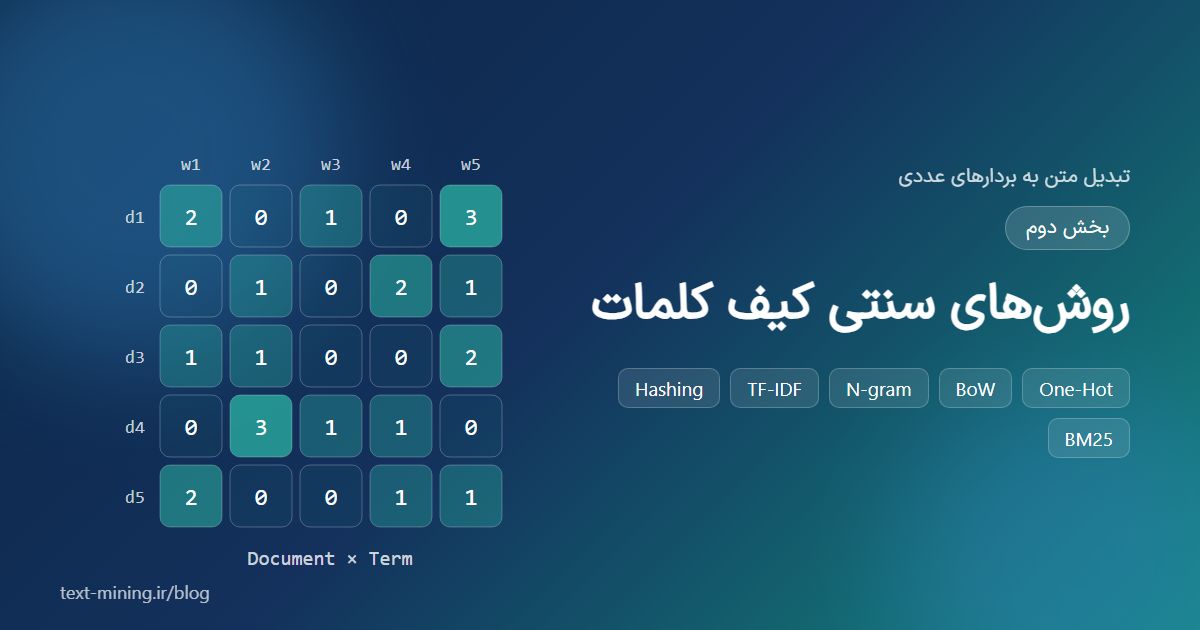
در بخش اول این مجموعه با هدف و دستهبندی کلی روشهای تبدیل متن به بردارهای عددی آشنا شدیم. در این بخش، قدیمیترین و در عین حال پرکاربردترین خانواده این روشها، یعنی رویکرد کیف کلمات (Bag-of-Words) و روشهای شمارشی را بررسی میکنیم. این روشها با وجود سادگی، هنوز در بسیاری از سامانههای واقعی (از فیلتر هرزنامه تا موتورهای جستجو) استفاده میشوند و یک خط مبنای (Baseline) ارزشمند برای مقایسه با روشهای پیچیدهتر هستند.
ایده اصلی: متن بهعنوان یک کیسه از کلمات
در مدل کیف کلمات، هر سند صرفاً بهصورت مجموعهای از کلمات (همراه با تعداد تکرار آنها) در نظر گرفته میشود و ترتیب، دستور زبان و ساختار جمله نادیده گرفته میشود. مراحل کار به این صورت است:
- توکنبندی: متن هر سند به واحدهای کوچکتر (معمولاً کلمه) شکسته میشود.
- ساخت واژگان (Vocabulary): مجموعه همه کلمات یکتای پیکره استخراج و به هر کلمه یک شماره (اندیس) اختصاص داده میشود.
- بردارسازی: هر سند به برداری به طول واژگان تبدیل میشود که خانه iام آن نشاندهنده حضور، تعداد تکرار یا وزن کلمه iام در آن سند است.
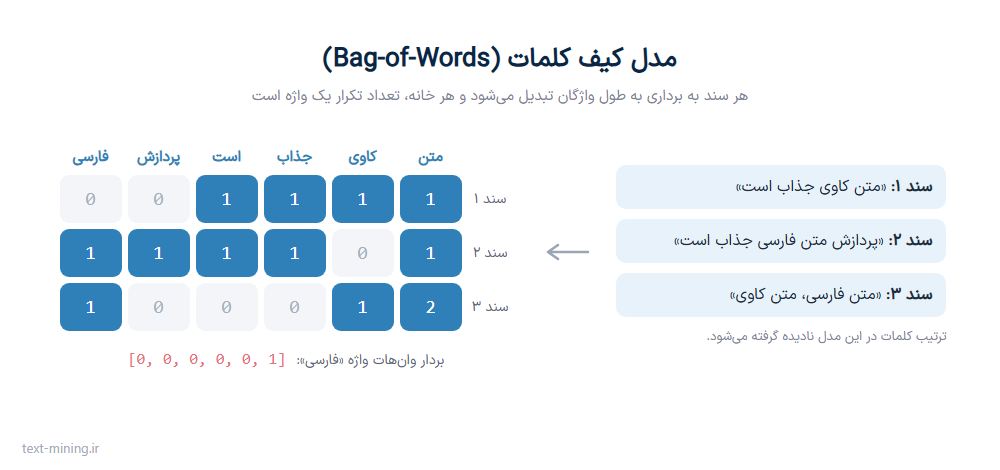
حاصل این فرایند برای کل پیکره، ماتریس سند-واژه (Document-Term Matrix) است که هر سطر آن بردار یک سند است. از آنجا که هر سند فقط بخش کوچکی از واژگان را شامل میشود، اغلب خانههای این ماتریس صفر هستند؛ به همین دلیل به این بردارها «پراکنده» (Sparse) میگویند و کتابخانهها آنها را در قالب ماتریسهای پراکنده (مانند scipy.sparse) ذخیره میکنند.
۱. کدگذاری وانهات و دودویی (One-Hot / Binary)
سادهترین نمایش یک کلمه، بردار وانهات است: برداری به طول واژگان که فقط در خانه متناظر آن کلمه مقدار ۱ و در بقیه خانهها صفر دارد. در نمایش دودویی یک سند، خانه هر کلمه در صورت حضور آن در سند ۱ و در غیر این صورت صفر است (تعداد تکرار مهم نیست).
مشکل اصلی بردارهای وانهات این است که همه کلمات به یک اندازه از هم فاصله دارند؛ یعنی شباهت «خودرو» و «ماشین» دقیقاً برابر با شباهت «خودرو» و «سیب» است (هر دو صفر). همچنین طول بردار با بزرگ شدن واژگان به دهها یا صدها هزار میرسد.
۲. بردارسازی شمارشی (Count Vectorizer)
در این روش مقدار هر خانه برابر با تعداد تکرار کلمه در سند است. کتابخانه scikit-learn این کار را با کلاس CountVectorizer انجام میدهد:
pip install scikit-learn hazm rank_bm25from sklearn.feature_extraction.text import CountVectorizer
docs = [
"متن کاوی جذاب است",
"پردازش متن فارسی جذاب است",
"متن فارسی، متن کاوی",
]
vectorizer = CountVectorizer()
X = vectorizer.fit_transform(docs) # ماتریس پراکنده سند-واژه
print(vectorizer.get_feature_names_out())
print(X.toarray())['است' 'جذاب' 'فارسی' 'متن' 'پردازش' 'کاوی']
[[1 1 0 1 0 1]
[1 1 1 1 1 0]
[0 0 1 2 0 1]]دقت کنید که ترتیب ستونها بر اساس ترتیب الفبایی یونیکد است (به همین دلیل «پ» و «ک» که کد یونیکد بزرگتری دارند در انتها آمدهاند). برای نمایش دودویی کافی است پارامتر binary=True را تنظیم کنید. همچنین پارامترهای min_df و max_df برای حذف کلمات بسیار نادر یا بسیار پرتکرار و max_features برای محدود کردن اندازه واژگان بسیار کاربردی هستند.
توکنبندی صحیح متن فارسی
الگوی پیشفرض توکنبندی در scikit-learn کلمات را بر اساس فاصله و علائم جدا میکند و نیمفاصله (ZWNJ) را جداکننده در نظر میگیرد؛ بنابراین «میروم» به دو توکن «می» و «روم» شکسته میشود (و توکنهای تکحرفی هم حذف میشوند). برای متون فارسی بهتر است نرمالسازی و توکنبندی را به یک ابزار مخصوص زبان فارسی مانند هضم بسپارید و کلمات توقف (Stop words) را حذف کنید:
from hazm import Normalizer, word_tokenize, stopwords_list
from sklearn.feature_extraction.text import CountVectorizer
normalizer = Normalizer()
vectorizer = CountVectorizer(
preprocessor=normalizer.normalize, # یکسانسازی نویسهها و نیمفاصلهها
tokenizer=word_tokenize, # توکنبندی مخصوص فارسی
token_pattern=None, # چون tokenizer سفارشی داریم
stop_words=stopwords_list(), # حذف کلمات توقف فارسی
min_df=2, # حذف کلماتی که فقط در یک سند آمدهاند
)۳. چندگانهها (N-gram) در سطح کلمه و حرف
برای جبران بخشی از اطلاعات ترتیب کلمات، میتوان علاوه بر تککلمهها (Unigram)، دنبالههای دوتایی (Bigram) یا سهتایی (Trigram) کلمات را نیز بهعنوان ویژگی در نظر گرفت. برای مثال در جمله «این فیلم خوب نبود»، ویژگی دوتایی «خوب نبود» اطلاعات بسیار مهمی برای تحلیل احساسات دارد که با تککلمهها از دست میرود.
چندگانههای حرفی (Character N-gram) نیز بهویژه برای زبان فارسی که ریختشناسی غنی، املای متنوع و غلطهای تایپی زیادی دارد بسیار مفیدند؛ زیرا «کتاب»، «کتابها» و «کتابخانه» حروف مشترک زیادی دارند:
from sklearn.feature_extraction.text import CountVectorizer
# تککلمهها و دوکلمهایها
word_ngrams = CountVectorizer(ngram_range=(1, 2))
X_words = word_ngrams.fit_transform(docs)
print(word_ngrams.get_feature_names_out()[:8])
# چندگانههای حرفی 2 تا 4 حرفی در محدوده هر کلمه
char_ngrams = CountVectorizer(analyzer="char_wb", ngram_range=(2, 4))
X_chars = char_ngrams.fit_transform(docs)
print(X_chars.shape)توجه داشته باشید که با افزایش n، تعداد ویژگیها به شدت افزایش مییابد؛ بنابراین معمولاً از n=1 تا ۲ برای کلمات و n=۲ تا ۵ برای حروف استفاده و ویژگیهای کمتکرار با min_df حذف میشوند.
۴. وزندهی TF-IDF
مشکل شمارش ساده این است که کلمات پرتکرار و عمومی (مانند «است»، «این» یا «را») بیشترین مقدار را میگیرند، در حالی که ارزش تمایزدهندگی کمی دارند. روش TF-IDF (Term Frequency – Inverse Document Frequency) وزن هر کلمه را از حاصلضرب دو عامل به دست میآورد:
- فراوانی واژه (TF): تعداد تکرار واژه t در سند d؛ هرچه بیشتر، کلمه برای آن سند مهمتر.
- معکوس فراوانی سند (IDF): لگاریتم نسبت تعداد کل اسناد (N) به تعداد اسنادی که واژه در آنها آمده (df). کلمهای که در همه اسناد هست، IDF نزدیک به صفر (یا کمینه) دارد و کلمه کمیاب، IDF بالا.
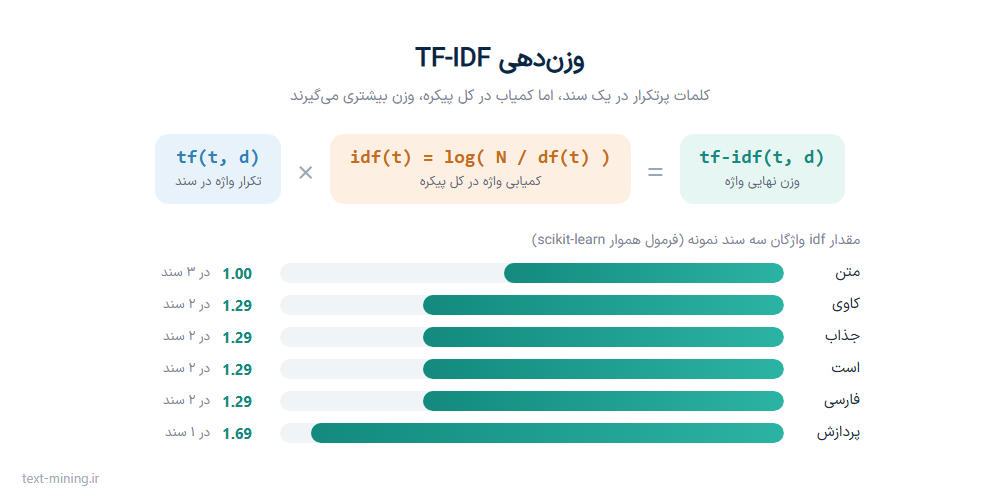
کتابخانه scikit-learn بهطور پیشفرض از نسخه «هموار» این فرمول استفاده میکند: idf(t) = ln((1 + N) / (1 + df(t))) + 1 و در پایان هر بردار را به طول واحد نرمال (L2) میکند تا طول سند در شباهت تأثیر نگذارد:
from sklearn.feature_extraction.text import TfidfVectorizer
tfidf = TfidfVectorizer() # smooth_idf=True و norm="l2" بصورت پیشفرض
X = tfidf.fit_transform(docs)
for word, idf in zip(tfidf.get_feature_names_out(), tfidf.idf_):
print(f"{word}: {idf:.2f}")است: 1.29
جذاب: 1.29
فارسی: 1.29
متن: 1.00
پردازش: 1.69
کاوی: 1.29همانطور که انتظار داریم، «متن» که در هر سه سند آمده کمترین وزن و «پردازش» که فقط در یک سند آمده بیشترین وزن را دارد. چند نکته کاربردی:
- پارامتر
sublinear_tf=Trueبهجای tf از1 + log(tf)استفاده میکند و اثر تکرار زیاد یک کلمه را تعدیل میکند؛ این تنظیم اغلب در دستهبندی متون دقت را افزایش میدهد. - شباهت دو سند با ضرب داخلی بردارهای نرمالشده (شباهت کسینوسی) محاسبه میشود:
(X @ X.T).toarray() - برای دادههای آزمون فقط از
transformاستفاده کنید تا واژگان و IDF از داده آموزش گرفته شوند.
مثال کامل: دستهبندی متون با TF-IDF
ترکیب TF-IDF با یک دستهبند خطی، یک خط مبنای سریع و قوی برای دستهبندی متن، تشخیص هرزنامه یا تحلیل احساسات است:
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import make_pipeline
from sklearn.model_selection import train_test_split
from sklearn.metrics import classification_report
# texts: لیست متون و labels: لیست برچسبها (مثلاً ورزشی، اقتصادی، سیاسی)
X_train, X_test, y_train, y_test = train_test_split(texts, labels, test_size=0.2, random_state=42)
clf = make_pipeline(
TfidfVectorizer(ngram_range=(1, 2), min_df=2, sublinear_tf=True),
LogisticRegression(max_iter=1000),
)
clf.fit(X_train, y_train)
print(classification_report(y_test, clf.predict(X_test)))یکی از مزایای مهم این روش تفسیرپذیری است: با بررسی ضرایب مدل خطی میتوان فهمید کدام کلمات بیشترین تأثیر را در تشخیص هر دسته داشتهاند. برای آزمایش روی داده واقعی فارسی میتوانید از پیکره اخبار فارسییار استفاده کنید.
۵. بردارسازی درهم (Hashing Vectorizer)
در پیکرههای بسیار بزرگ یا دادههای جریانی (Streaming) نگهداری واژگان در حافظه مشکلساز است. «ترفند درهمسازی» (Hashing Trick) بهجای واژگان، اندیس هر کلمه را مستقیماً با یک تابع درهمساز (Hash) و باقیمانده بر تعداد ثابت ویژگیها محاسبه میکند. بنابراین نیازی به ساخت و ذخیره واژگان نیست و مدل را میتوان بصورت افزایشی (با partial_fit) آموزش داد:
from sklearn.feature_extraction.text import HashingVectorizer

hasher = HashingVectorizer(n_features=2**18, alternate_sign=False, norm="l2")
X = hasher.transform(docs)     # نیازی به fit نیست
print(X.shape)                 # (3, 262144)
عیب این روش، امکان «برخورد» (Collision) دو کلمه در یک خانه و از دست رفتن امکان بازگرداندن اندیس به کلمه (تفسیرپذیری) است. با انتخاب تعداد ویژگی کافی (مثلاً ۲ به توان ۱۸ یا بیشتر) اثر برخوردها ناچیز میشود. برای اعمال IDF میتوان خروجی را به TfidfTransformer داد.
۶. وزندهی BM25 برای جستجو
BM25 (Best Matching 25) نسخه بهبودیافته و احتمالاتی TF-IDF است که هنوز تابع رتبهبندی پیشفرض موتورهای جستجویی مانند Elasticsearch و OpenSearch است. دو تفاوت مهم آن با TF-IDF عبارتاند از:
- اشباع فراوانی: با پارامتر k1، اثر تکرار زیاد یک کلمه محدود میشود (تکرار دهم یک کلمه ارزش بسیار کمتری از تکرار اول دارد).
- نرمالسازی طول سند: با پارامتر b، اسناد طولانی که بهطور طبیعی کلمات بیشتری دارند جریمه میشوند.
from hazm import word_tokenize
from rank_bm25 import BM25Okapi
corpus = [word_tokenize(d) for d in docs]
bm25 = BM25Okapi(corpus, k1=1.5, b=0.75)
query = word_tokenize("پردازش متن فارسی")
print(bm25.get_scores(query)) # امتیاز هر سند
print(bm25.get_top_n(query, docs, n=2)) # دو سند مرتبطترامروزه BM25 در کنار مدلهای تعبیه معنایی (که در بخش ششم معرفی میشوند) در «جستجوی ترکیبی» (Hybrid Search) استفاده میشود؛ زیرا BM25 در تطبیق دقیق نامها، کدها و اصطلاحات تخصصی بسیار خوب عمل میکند.
مزایا و معایب روشهای کیف کلمات
| مزایا | معایب |
|---|---|
| پیادهسازی ساده و سرعت بسیار بالا، بدون نیاز به GPU | ابعاد بسیار زیاد و بردارهای پراکنده |
| تفسیرپذیری کامل (هر بُعد یک کلمه است) | نادیده گرفتن ترتیب کلمات و ساختار جمله |
| عملکرد خوب در دستهبندی متون با داده کم یا متوسط | عدم درک هممعنایی («خودرو» و «ماشین» بیارتباطاند) |
| تطبیق دقیق کلیدواژهها در جستجو (BM25) | عدم درک چندمعنایی («شیر» همیشه یک ویژگی است) |
| عدم نیاز به داده آموزشی بزرگ یا مدل از پیش آموزشدیده | حساسیت زیاد به پیشپردازش، املا و نیمفاصله |
برای حل مشکل ابعاد بالا و کشف ارتباطهای پنهان بین کلمات، در بخش سوم روشهای کاهش ابعاد و مدلهای موضوعی را بررسی میکنیم.
منابع
- Sparck Jones, K. (1972). A statistical interpretation of term specificity and its application in retrieval. Journal of Documentation, 28(1). doi:10.1108/eb026526
- Salton, G., & Buckley, C. (1988). Term-weighting approaches in automatic text retrieval. Information Processing & Management, 24(5). doi:10.1016/0306-4573(88)90021-0
- Robertson, S., & Zaragoza, H. (2009). The Probabilistic Relevance Framework: BM25 and Beyond. Foundations and Trends in Information Retrieval, 3(4). doi:10.1561/1500000019
- Weinberger, K., et al. (2009). Feature Hashing for Large Scale Multitask Learning. ICML. arXiv:0902.2206
- Manning, C. D., Raghavan, P., & Schütze, H. (2008). Introduction to Information Retrieval, فصل ۶: Scoring, term weighting and the vector space model. nlp.stanford.edu/IR-book
- مستندات scikit-learn: Text feature extraction
- کتابخانه rank_bm25: github.com/dorianbrown/rank_bm25
- کتابخانه هضم: github.com/roshan-research/hazm
استفاده از این مقاله با ذکر منبع «سامانه متن کاوی فارسییار – text-mining.ir»، بلامانع است.