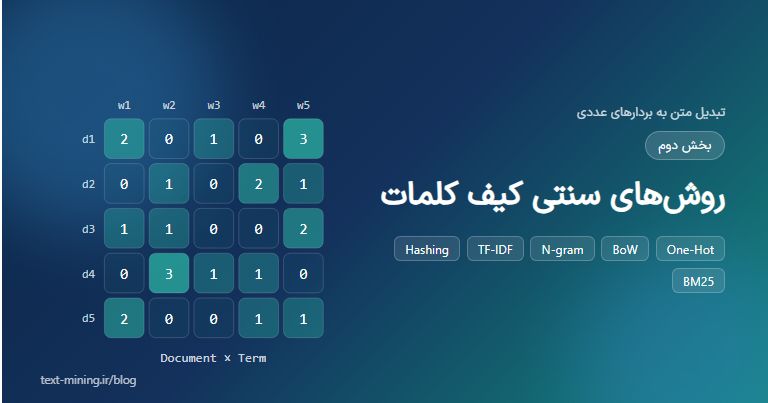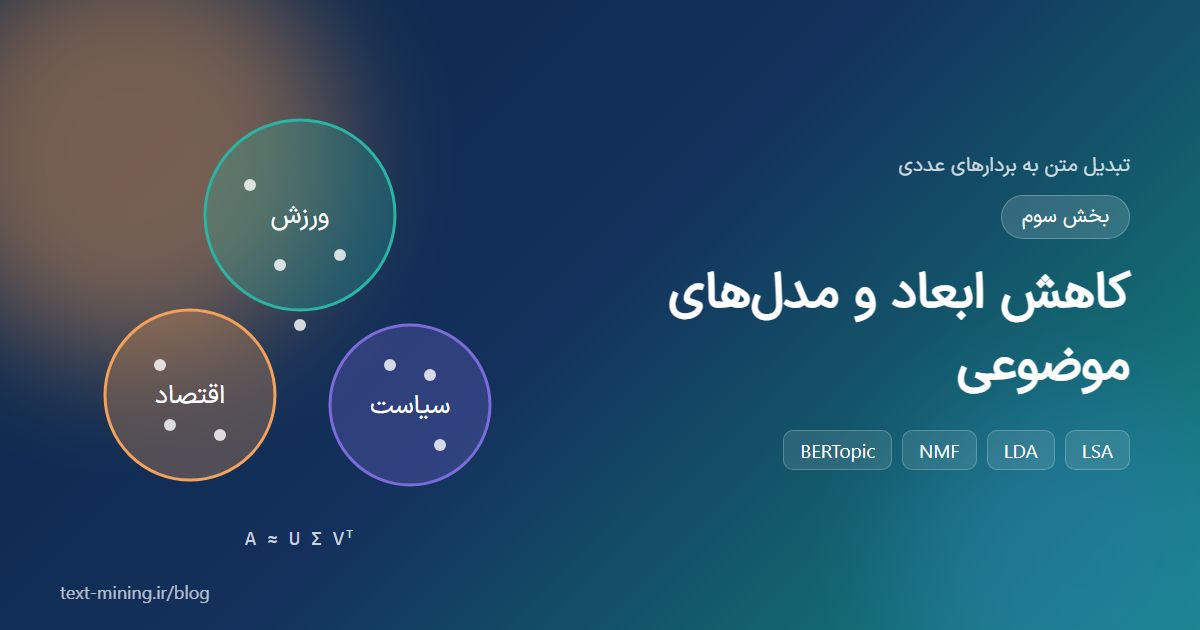
در بخش دوم دیدیم که روشهای کیف کلمات بردارهایی با دهها هزار بُعد تولید میکنند که اغلب خانههای آنها صفر است و هیچ ارتباطی بین کلمات هممعنا برقرار نمیکنند. در این بخش روشهایی را بررسی میکنیم که با تحلیل الگوهای همرخدادی (Co-occurrence) کلمات در اسناد، ماتریس بزرگ سند-واژه را به فضایی کمبُعد و معنادار نگاشت میکنند. در این فضا هر بُعد یک «مفهوم» یا «موضوع» پنهان است و اسناد مرتبط حتی بدون کلمات مشترک نیز به هم نزدیک میشوند.
چرا کاهش ابعاد؟
- نفرین ابعاد (Curse of Dimensionality): در فضاهای بسیار پرُبعد، فاصلهها معنای خود را از دست میدهند و بسیاری از الگوریتمها (مانند خوشهبندی K-Means یا نزدیکترین همسایه) کارایی کمتری پیدا میکنند.
- هممعنایی (Synonymy): سندی درباره «خودرو» و سندی درباره «اتومبیل» در مدل کیف کلمات هیچ شباهتی ندارند؛ اما چون هر دو کلمه با «موتور»، «رانندگی» و «جاده» همرخداد هستند، در فضای مفاهیم به هم نزدیک میشوند.
- کاهش نویز و حجم: بردار ۱۰۰ بُعدی چگال برای ذخیره، جستجو و آموزش مدل بسیار ارزانتر از بردار ۵۰ هزار بُعدی است.
- تفسیر و کشف دانش: مدلهای موضوعی، موضوعات اصلی یک پیکره بزرگ (مثلاً هزاران خبر یا نظر مشتری) را بصورت خودکار و بدون نیاز به برچسب کشف میکنند.
۱. تحلیل معنایی پنهان (LSA / LSI)
تحلیل معنایی پنهان (Latent Semantic Analysis) که در بازیابی اطلاعات به آن نمایهسازی معنایی پنهان (LSI) نیز گفته میشود، در سال ۱۹۹۰ معرفی شد. این روش ماتریس سند-واژه (معمولاً با وزن TF-IDF) را با تجزیه مقادیر منفرد (Singular Value Decomposition – SVD) به سه ماتریس تجزیه میکند و فقط k مؤلفه با بزرگترین مقادیر منفرد را نگه میدارد:
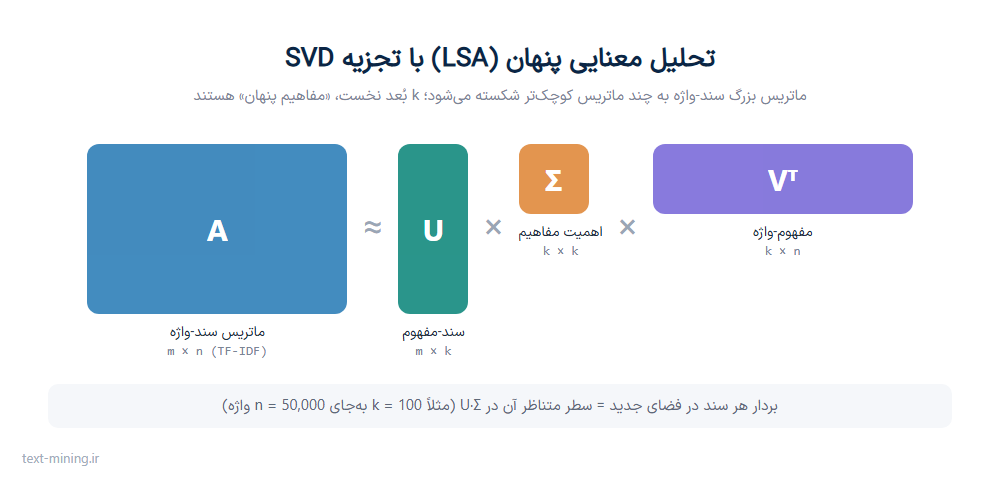
- U: ارتباط هر سند با هر مفهوم؛ سطرهای
U·Σبردار جدید اسناد هستند. - Σ: ماتریس قطری مقادیر منفرد که اهمیت هر مفهوم را نشان میدهد.
- Vᵀ: ارتباط هر مفهوم با هر واژه؛ ستونهای آن را میتوان بردار کلمات در فضای مفاهیم دانست.
در scikit-learn از TruncatedSVD استفاده میشود که برخلاف PCA مستقیماً روی ماتریسهای پراکنده کار میکند. نرمال کردن خروجی، شباهت کسینوسی را در فضای جدید معنادار میکند:
pip install scikit-learn gensim hazm bertopicfrom sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.decomposition import TruncatedSVD
from sklearn.preprocessing import Normalizer
from sklearn.pipeline import make_pipeline
# docs: لیستی از چند هزار سند متنی (مثلاً اخبار)
lsa = make_pipeline(
TfidfVectorizer(min_df=5, max_df=0.5, sublinear_tf=True),
TruncatedSVD(n_components=100, random_state=42),
Normalizer(copy=False),
)
X_lsa = lsa.fit_transform(docs) # shape: (n_docs, 100)
svd = lsa.named_steps["truncatedsvd"]
print("سهم واریانس حفظ شده:", svd.explained_variance_ratio_.sum())
# شباهت سند اول با همه اسناد در فضای مفاهیم
similarities = X_lsa @ X_lsa[0]
print(similarities.argsort()[::-1][:5]) # 5 سند مشابهترLSA سریع و قطعی (Deterministic) است، اما ابعاد آن ممکن است مقادیر منفی داشته باشند و تفسیر هر بُعد بهعنوان یک موضوع دشوار است. همچنین با اضافه شدن اسناد جدید باید تجزیه دوباره انجام شود (یا اسناد جدید با transform روی همان پایه نگاشت شوند).
۲. تخصیص پنهان دیریکله (LDA)
LDA (Latent Dirichlet Allocation) که در سال ۲۰۰۳ توسط بلی، انگ و جردن معرفی شد، یک مدل مولد احتمالاتی است. فرض LDA این است که هر سند ترکیبی از چند موضوع است و هر موضوع یک توزیع احتمال روی کلمات است. مدل با مشاهده اسناد، این دو توزیع را تخمین میزند؛ در نتیجه بردار هر سند، سهم هر موضوع در آن سند است (برداری با مقادیر نامنفی که جمع آنها یک است).
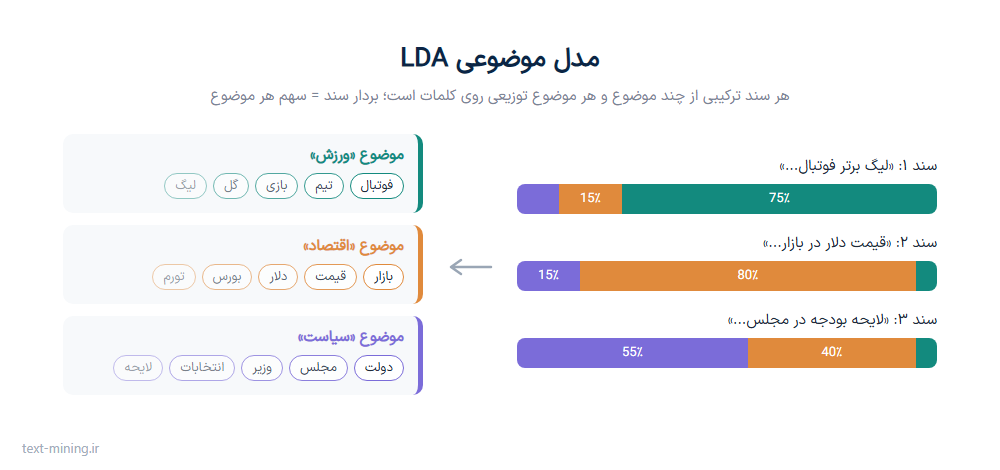
چون LDA یک مدل احتمالاتی روی تعداد کلمات است، ورودی آن باید ماتریس شمارشی (و نه TF-IDF) باشد. پیادهسازی scikit-learn:
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.decomposition import LatentDirichletAllocation
from hazm import stopwords_list

counter = CountVectorizer(max_df=0.9, min_df=5, stop_words=stopwords_list())
X_counts = counter.fit_transform(docs)

lda = LatentDirichletAllocation(n_components=10, learning_method="online", random_state=0)
doc_topics = lda.fit_transform(X_counts)   # بردار موضوعی اسناد، shape: (n_docs, 10)

# نمایش 8 کلمه مهم هر موضوع
words = counter.get_feature_names_out()
for k, topic in enumerate(lda.components_):
    top = [words[i] for i in topic.argsort()[::-1][:8]]
    print(f"موضوع {k}: {'، '.join(top)}")
کتابخانه gensim پیادهسازی بهینهتری برای پیکرههای بزرگ دارد و امکان محاسبه انسجام موضوعی (Topic Coherence) را برای انتخاب بهترین تعداد موضوع فراهم میکند:
from gensim import corpora
from gensim.models import LdaModel, CoherenceModel
from hazm import word_tokenize

texts = [word_tokenize(d) for d in docs]          # بهتر است کلمات توقف نیز حذف شوند
dictionary = corpora.Dictionary(texts)
dictionary.filter_extremes(no_below=5, no_above=0.5)
corpus = [dictionary.doc2bow(t) for t in texts]

lda = LdaModel(corpus, num_topics=10, id2word=dictionary, passes=10, random_state=0)
print(lda.print_topics(num_words=8))

coherence = CoherenceModel(model=lda, texts=texts, dictionary=dictionary, coherence="c_v")
print("انسجام موضوعی:", coherence.get_coherence())

# بردار موضوعی یک سند جدید
bow = dictionary.doc2bow(word_tokenize("قیمت دلار در بازار امروز کاهش یافت"))
print(lda.get_document_topics(bow))
چند نکته مهم در استفاده از LDA:
- تعداد موضوعات (k) را باید از پیش تعیین کرد؛ معمولاً چند مقدار آزمایش و بر اساس انسجام موضوعی و بررسی انسانی انتخاب میشود.
- LDA به پیشپردازش (حذف کلمات توقف، ریشهیابی یا Lemmatization و حذف کلمات بسیار نادر) حساس است.
- LDA روی متون بسیار کوتاه (مانند توییت یا عنوان) عملکرد ضعیفی دارد، چون همرخدادی کافی در هر سند وجود ندارد.
۳. تجزیه ماتریس نامنفی (NMF)
NMF (Non-negative Matrix Factorization) ماتریس نامنفی سند-واژه A را به حاصلضرب دو ماتریس نامنفی W (سند-موضوع) و H (موضوع-واژه) تجزیه میکند. محدودیت نامنفی بودن باعث میشود هر سند «جمع» چند موضوع باشد و موضوعات معمولاً تفسیرپذیرتر از LSA باشند. NMF روی ماتریس TF-IDF اجرا میشود و اغلب سریعتر از LDA به موضوعات منسجم میرسد:
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.decomposition import NMF

tfidf = TfidfVectorizer(max_df=0.9, min_df=5)
X = tfidf.fit_transform(docs)

nmf = NMF(n_components=10, init="nndsvda", random_state=0, max_iter=400)
W = nmf.fit_transform(X)      # بردار هر سند در فضای موضوعات
H = nmf.components_           # اهمیت هر کلمه در هر موضوع

words = tfidf.get_feature_names_out()
for k, topic in enumerate(H):
    print(k, [words[i] for i in topic.argsort()[::-1][:8]])
۴. مدلسازی موضوعی مبتنی بر تعبیهها (BERTopic)
BERTopic پلی بین روشهای کلاسیک و مدلهای نوین است. این روش ابتدا هر سند را با یک مدل تعبیه جمله (که در بخش ششم معرفی میشود) به بردار تبدیل میکند، سپس ابعاد را با UMAP کاهش داده، اسناد را با HDBSCAN خوشهبندی میکند و در نهایت با نسخهای از TF-IDF در سطح خوشه (c-TF-IDF) کلمات کلیدی هر موضوع را استخراج میکند. مزیت آن درک معنایی بهتر، عدم نیاز به تعیین تعداد موضوعات و عملکرد خوب روی متون کوتاه است:
from bertopic import BERTopic

topic_model = BERTopic(language="multilingual", min_topic_size=20)
topics, probs = topic_model.fit_transform(docs)   # docs: حداقل چند صد سند

print(topic_model.get_topic_info().head(10))       # فهرست موضوعات و تعداد اسناد
print(topic_model.get_topic(0))                    # کلمات کلیدی موضوع 0
مقایسه روشها
| روش | ورودی | مبنا | تفسیرپذیری موضوعات | مناسب برای |
|---|---|---|---|---|
| LSA | TF-IDF | جبر خطی (SVD) | کم | کاهش ابعاد سریع، بازیابی اطلاعات |
| LDA | شمارش کلمات | احتمالاتی (بیزی) | خوب | تحلیل موضوعی اسناد بلند |
| NMF | TF-IDF | تجزیه نامنفی | خوب | موضوعات منسجم با سرعت بالا |
| BERTopic | متن خام | تعبیه + خوشهبندی | بسیار خوب | متون کوتاه، درک معنایی، چندزبانه |
روشهای این بخش اسناد را به بردارهای معنادار تبدیل میکنند، اما هنوز برای هر کلمه بردار مستقل و قابل انتقالی یاد نمیگیرند. در بخش چهارم به سراغ روشهای تعبیه کلمات میرویم که با شبکههای عصبی، برای هر کلمه یک بردار چگال یاد میگیرند.
منابع
- Deerwester, S., Dumais, S. T., Furnas, G. W., Landauer, T. K., & Harshman, R. (1990). Indexing by Latent Semantic Analysis. Journal of the American Society for Information Science, 41(6).
- Blei, D. M., Ng, A. Y., & Jordan, M. I. (2003). Latent Dirichlet Allocation. Journal of Machine Learning Research, 3. jmlr.org/papers/v3/blei03a
- Lee, D. D., & Seung, H. S. (1999). Learning the parts of objects by non-negative matrix factorization. Nature, 401. doi:10.1038/44565
- Röder, M., Both, A., & Hinneburg, A. (2015). Exploring the Space of Topic Coherence Measures. WSDM. doi:10.1145/2684822.2685324
- Grootendorst, M. (2022). BERTopic: Neural topic modeling with a class-based TF-IDF procedure. arXiv:2203.05794
- مستندات scikit-learn: Decomposing signals in components
- مستندات gensim: models.ldamodel
- مستندات BERTopic: maartengr.github.io/BERTopic
استفاده از این مقاله با ذکر منبع «سامانه متن کاوی فارسییار – text-mining.ir»، بلامانع است.