در بخش چهارم دیدیم که روشهای تعبیه ایستا مانند Word2Vec و FastText برای هر کلمه فقط یک بردار ثابت تولید میکنند. اما معنای کلمات در زبان طبیعی به بافت (Context) وابسته است. از سال ۲۰۱۸ نسل جدیدی از مدلها پدید آمد که بردار هر کلمه را با توجه به کل جمله محاسبه میکنند. این مدلها که روی میلیاردها کلمه از پیش آموزش داده شدهاند، تحولی بنیادین در همه وظایف پردازش زبان طبیعی ایجاد کردند و پایه مدلهای زبانی بزرگ امروزی هستند.
مشکل چندمعنایی و ایده تعبیه بافتاری
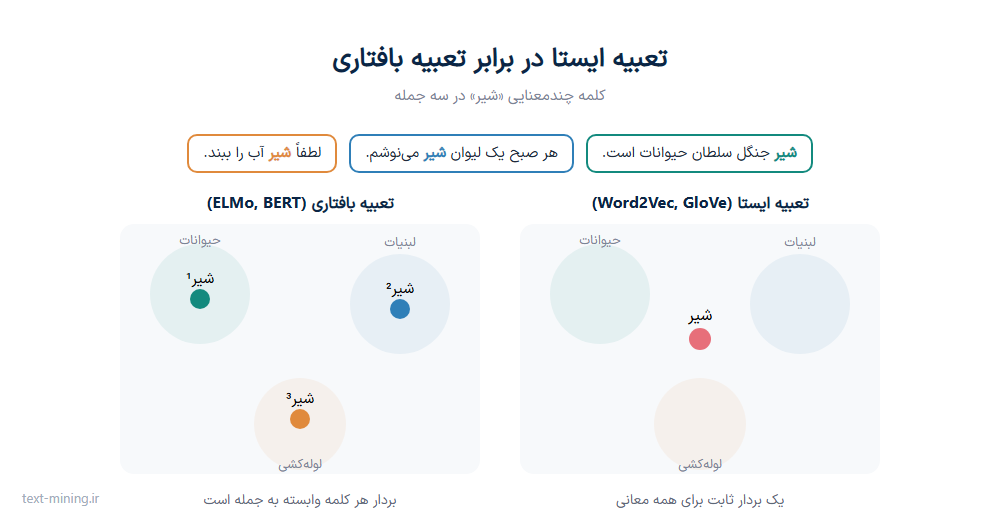
کلمه «شیر» را در نظر بگیرید. در یک مدل ایستا، این کلمه یک نقطه در فضای برداری است که جایی بین معانی «حیوان»، «نوشیدنی» و «شیرآلات» قرار میگیرد. در مدلهای بافتاری، هر بار که کلمه در جملهای ظاهر میشود، بردار جدیدی متناسب با همان جمله تولید میشود:
۱. ELMo: تعبیه از مدل زبانی دوطرفه
ELMo (Embeddings from Language Models) که در سال ۲۰۱۸ توسط مؤسسه AllenAI معرفی شد، یکی از اولین مدلهای موفق تعبیه بافتاری بود. ELMo از دو شبکه LSTM چندلایه استفاده میکند: یکی متن را از چپ به راست و دیگری از راست به چپ میخواند و هر کدام کلمه بعدی (یا قبلی) را پیشبینی میکند. بردار نهایی هر کلمه، ترکیب وزندار حالتهای پنهان همه لایههای دو شبکه است. همچنین ورودی ELMo در سطح حروف است و بنابراین کلمه خارج از واژگان ندارد.
ELMo نشان داد که استفاده از بردارهای بافتاری از پیش آموزشدیده، دقت تقریباً همه وظایف پردازش زبان را بهطور چشمگیری بهبود میدهد. با این حال، به دلیل ماهیت ترتیبی LSTM، آموزش آن کند است و امروزه جای خود را به مدلهای مبتنی بر ترنسفورمر داده است.
۲. ترنسفورمر و سازوکار توجه
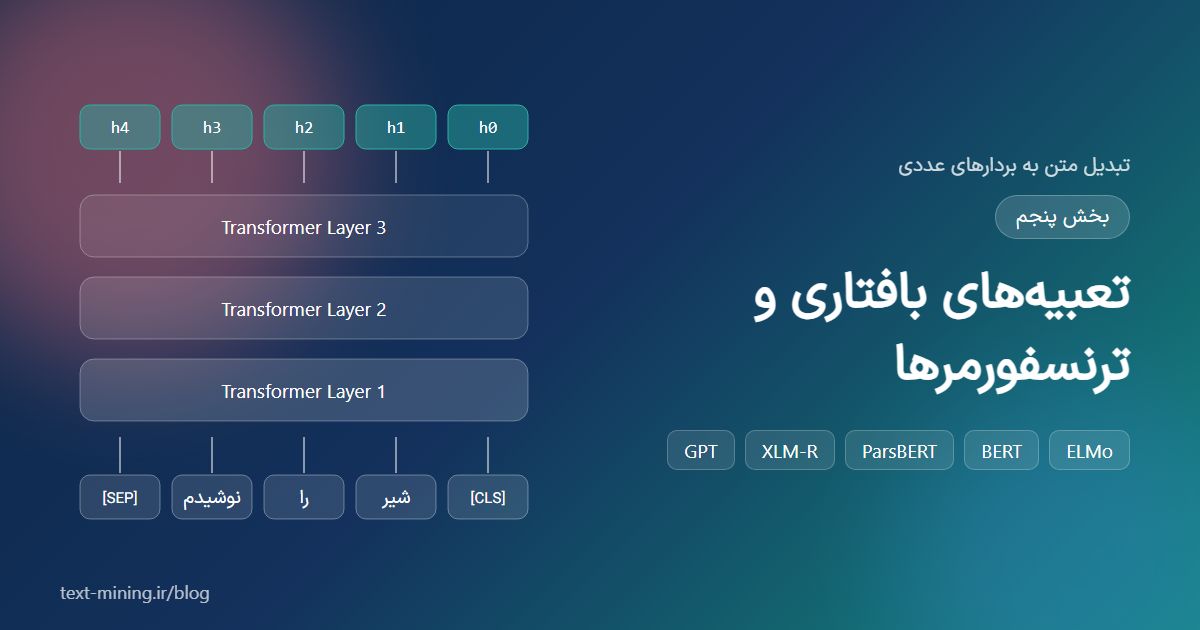
معماری ترنسفورمر (Transformer) در سال ۲۰۱۷ در مقاله مشهور «توجه، تمام آن چیزی است که نیاز دارید» معرفی شد. قلب این معماری، توجه به خود (Self-Attention) است: هنگام ساخت بردار هر کلمه، مدل با محاسبه یک وزن (میزان توجه) برای همه کلمات دیگر جمله، اطلاعات مرتبط را از آنها جمعآوری میکند. برای مثال در جمله «شیر را از یخچال برداشتم و نوشیدم»، توجه کلمه «شیر» روی «یخچال» و «نوشیدم» زیاد خواهد بود. مزایای اصلی ترنسفورمر عبارتاند از:
- پردازش موازی همه کلمات (برخلاف LSTM) و در نتیجه امکان آموزش روی دادههای بسیار بزرگ با GPU
- مدلسازی مستقیم وابستگیهای دور بین کلمات
- توجه چندسر (Multi-Head Attention) برای یادگیری همزمان انواع روابط نحوی و معنایی
۳. BERT: رمزگذار دوطرفه ترنسفورمر
BERT (Bidirectional Encoder Representations from Transformers) که در اواخر سال ۲۰۱۸ توسط گوگل معرفی شد، فقط از بخش رمزگذار ترنسفورمر استفاده میکند و با دو وظیفه خودنظارتی روی حجم عظیمی از متن بدون برچسب پیشآموزش میبیند:
- مدل زبانی نقابدار (Masked Language Model): حدود ۱۵ درصد توکنها پوشانده میشوند و مدل باید آنها را با توجه به کلمات دو طرف حدس بزند.
- پیشبینی جمله بعدی (Next Sentence Prediction): تشخیص اینکه آیا جمله دوم واقعاً بعد از جمله اول آمده است یا نه (در مدلهای بعدی مانند RoBERTa حذف شد).
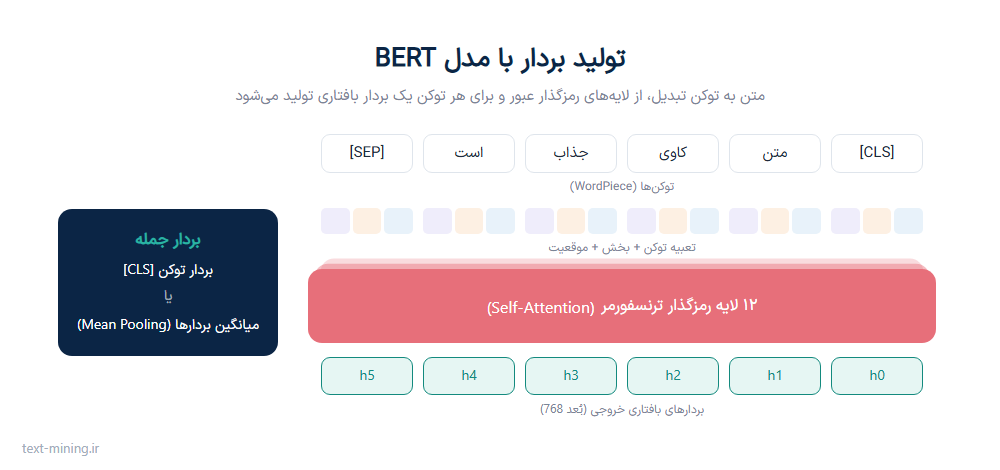
متن ورودی ابتدا با الگوریتم WordPiece به زیرکلمهها (توکنها) شکسته میشود؛ مثلاً کلمهای نادر ممکن است به چند قطعه تقسیم شود. توکن ویژه [CLS] در ابتدا و [SEP] در انتهای جمله اضافه میشوند. خروجی مدل پایه (Base) برای هر توکن برداری ۷۶۸ بُعدی است. برای ساخت بردار کل جمله دو روش رایج وجود دارد: استفاده از بردار [CLS] یا میانگینگیری از بردار همه توکنها (Mean Pooling) که معمولاً نتیجه بهتری دارد.
مدلهای فارسی و چندزبانه
- ParsBERT: مدل BERT تکزبانه فارسی که توسط گروه هوشواره روی پیکره بزرگی از متون فارسی آموزش داده شده است (
HooshvareLab/bert-fa-zwnj-baseنسخهای است که نیمفاصله را بهدرستی پردازش میکند). - mBERT: نسخه چندزبانه BERT که روی ویکیپدیای ۱۰۴ زبان آموزش دیده است (
bert-base-multilingual-cased). - XLM-RoBERTa: مدل چندزبانه فیسبوک بر پایه RoBERTa که روی ۲.۵ ترابایت داده Common Crawl در ۱۰۰ زبان (از جمله حجم قابل توجهی متن فارسی) آموزش دیده و در وظایف فارسی بسیار قوی است (
xlm-roberta-baseوxlm-roberta-large). - سایر مدلهای خانواده BERT مانند RoBERTa، DistilBERT (نسخه سبک و سریع)، ALBERT و ELECTRA نیز با همین رابط قابل استفاده هستند.
استخراج بردار با کتابخانه Transformers
کتابخانه Transformers شرکت Hugging Face استاندارد استفاده از این مدلها در پایتون است:
pip install transformers torchimport torch
from transformers import AutoTokenizer, AutoModel
model_name = "HooshvareLab/bert-fa-zwnj-base"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModel.from_pretrained(model_name)
model.eval()
inputs = tokenizer("متن کاوی فارسی جذاب است", return_tensors="pt")
print(tokenizer.convert_ids_to_tokens(inputs["input_ids"][0]))
with torch.no_grad():
outputs = model(**inputs)
token_vectors = outputs.last_hidden_state # shape: (1, n_tokens, 768)
cls_vector = token_vectors[:, 0] # بردار توکن [CLS]
print(token_vectors.shape, cls_vector.shape)برای ساخت بردار جمله با میانگینگیری، باید توکنهای پرکننده (Padding) را با attention_mask کنار گذاشت تا بتوان چند جمله با طول متفاوت را با هم پردازش کرد:
def mean_pooling(last_hidden_state, attention_mask):
    mask = attention_mask.unsqueeze(-1).float()            # (batch, seq, 1)
    summed = (last_hidden_state * mask).sum(dim=1)
    counts = mask.sum(dim=1).clamp(min=1e-9)
    return summed / counts

sentences = ["هوا امروز آفتابی است", "قیمت طلا افزایش یافت"]
batch = tokenizer(sentences, padding=True, truncation=True, max_length=256, return_tensors="pt")

with torch.no_grad():
    output = model(**batch)

sentence_vectors = mean_pooling(output.last_hidden_state, batch["attention_mask"])
print(sentence_vectors.shape)   # (2, 768)
آزمایش: بردار «شیر» در سه جمله
با کد زیر میتوانید بردار یک کلمه را در جملات مختلف استخراج و با هم مقایسه کنید. اگر کلمه به چند زیرکلمه شکسته شود، میانگین بردار آنها محاسبه میشود:
import torch.nn.functional as F
def word_vector(sentence, word):
words = sentence.split()
enc = tokenizer(words, is_split_into_words=True, return_tensors="pt")
with torch.no_grad():
hidden = model(**enc).last_hidden_state[0]
index = words.index(word)
positions = [i for i, w in enumerate(enc.word_ids()) if w == index]
return hidden[positions].mean(dim=0)
lion = word_vector("شیر جنگل سلطان حیوانات است", "شیر")
milk = word_vector("هر صبح یک لیوان شیر مینوشم", "شیر")
milk2 = word_vector("شیر گاو سرشار از کلسیم است", "شیر")
print("شیر (حیوان) و شیر (نوشیدنی):", F.cosine_similarity(lion, milk, dim=0).item())
print("شیر (نوشیدنی) و شیر (نوشیدنی):", F.cosine_similarity(milk, milk2, dim=0).item())انتظار داریم شباهت دو کاربرد «شیر» به معنای نوشیدنی، بیشتر از شباهت آن با «شیر» به معنای حیوان باشد؛ چیزی که در Word2Vec هرگز ممکن نیست، چون هر سه بردار یکساناند.
تنظیم دقیق (Fine-tuning)
قدرت اصلی BERT در «انتقال یادگیری» است: مدل از پیش آموزشدیده با افزودن یک لایه ساده روی خروجی و آموزش مختصر روی داده برچسبدار (مثلاً چند هزار نمونه)، برای وظیفهای مانند دستهبندی متن، تحلیل احساسات یا تشخیص موجودیتهای نامی تنظیم میشود و معمولاً به دقتی بسیار بالاتر از روشهای سنتی میرسد:
from transformers import AutoModelForSequenceClassification, pipeline
classifier = AutoModelForSequenceClassification.from_pretrained(model_name, num_labels=3)
# ... آموزش با transformers.Trainer روی داده برچسبدار
# استخراج سریع ویژگیها بدون نوشتن کد مدل
extractor = pipeline("feature-extraction", model=model_name, tokenizer=model_name)
features = extractor("متن کاوی فارسی") # لیست تودرتو: [1][تعداد توکنها][768]۴. مدلهای رمزگشا و خانواده GPT
در کنار مدلهای رمزگذار مانند BERT، مدلهای رمزگشا (Decoder-only) مانند GPT، GPT-2 و نسلهای بعدی مدلهای زبانی بزرگ، متن را فقط از چپ به راست (یکطرفه) پردازش و کلمه بعدی را پیشبینی میکنند. همچنین مدلهایی مانند XLNet و Transformer-XL با رویکردهای دیگر پیشآموزش و پشتیبانی از متون طولانیتر معرفی شدند.
بردارهای خام مدلهای رمزگشا (مثلاً حالت پنهان آخرین توکن) بدون آموزش ویژه، معمولاً برای سنجش شباهت معنایی مناسب نیستند. به همین دلیل، همانطور که در بخش ششم میبینیم، مدلهای تعبیه مبتنی بر LLM با آموزش تقابلی جداگانه ساخته میشوند.
جمعبندی و محدودیتها
| مدل | سال | معماری | جهت پردازش | ابعاد بردار |
|---|---|---|---|---|
| ELMo | ۲۰۱۸ | LSTM دوطرفه | دوطرفه (جداگانه) | ۱۰۲۴ |
| BERT / ParsBERT | ۲۰۱۸ / ۲۰۲۰ | رمزگذار ترنسفورمر | دوطرفه | ۷۶۸ (Base)، ۱۰۲۴ (Large) |
| XLM-RoBERTa | ۲۰۱۹ | رمزگذار ترنسفورمر | دوطرفه | ۷۶۸ / ۱۰۲۴ |
| GPT و LLMها | ۲۰۱۸ به بعد | رمزگشای ترنسفورمر | یکطرفه | ۷۶۸ تا چند هزار |
با اینکه بردارهای BERT برای تنظیم دقیق فوقالعادهاند، پژوهشها نشان داد که بردار [CLS] یا میانگین توکنهای یک BERT خام، برای سنجش مستقیم شباهت معنایی دو جمله حتی ممکن است از میانگین ساده بردارهای GloVe ضعیفتر باشد. همچنین مقایسه دو جمله با قرار دادن هر دو در ورودی BERT (رمزگذار متقاطع) برای جستجو در میلیونها سند بسیار کند است. راهحل این مشکلات، مدلهای تعبیه جمله است که در بخش ششم و پایانی این مجموعه معرفی میشوند.
منابع
- Peters, M. E., et al. (2018). Deep contextualized word representations. NAACL. arXiv:1802.05365
- Vaswani, A., et al. (2017). Attention Is All You Need. NeurIPS. arXiv:1706.03762
- Devlin, J., Chang, M.-W., Lee, K., & Toutanova, K. (2019). BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding. NAACL. arXiv:1810.04805
- Liu, Y., et al. (2019). RoBERTa: A Robustly Optimized BERT Pretraining Approach. arXiv:1907.11692
- Conneau, A., et al. (2020). Unsupervised Cross-lingual Representation Learning at Scale (XLM-R). ACL. arXiv:1911.02116
- Farahani, M., Gharachorloo, M., Farahani, M., & Manthouri, M. (2021). ParsBERT: Transformer-based Model for Persian Language Understanding. Neural Processing Letters. arXiv:2005.12515
- Radford, A., et al. (2019). Language Models are Unsupervised Multitask Learners (GPT-2). OpenAI.
- Sanh, V., et al. (2019). DistilBERT, a distilled version of BERT. arXiv:1910.01108
- مستندات Hugging Face Transformers: huggingface.co/docs/transformers
- مدل ParsBERT: huggingface.co/HooshvareLab/bert-fa-zwnj-base
استفاده از این مقاله با ذکر منبع «سامانه متن کاوی فارسییار – text-mining.ir»، بلامانع است.