استخراج و انتخاب ویژگیهای مناسب (Relevant features) از یک مجموعه داده نقش حیاتی در بهبود کیفیت و کارایی روشهای یادگیری ماشین دارند. خصوصاً در دادههای با تعداد ابعاد بالا مانند متون، دادههای بیان ژنی (Gene expression data)، تصویر، صوت، ویدئو و غیره انتخاب ویژگی امری ضروری است.
هدف از استخراج ویژگیهای عددی از متن
اغلب روشهای یادگیری ماشین بر روی دادههای عددی قابل اجرا هستند و برای استفاده و اجرای آنها روی دادههای متنی نیاز به تبدیل متون به مجموعه اعداد است. پس هدف رویکردهای مختلف تبدیل متن به بردارهای عددی، استخراج و انتخاب مجموعهای از ویژگیهای مناسب از متون زبان طبیعی است که در مرحله بعد بوسیله روشهای یادگیری ماشین از قبیل دستهبندی متون (Text classification)، خوشهبندی (Clustering)، جستجوی معنایی (Semantic search) و … استفاده میشوند. بطور کلی، استخراج ویژگی از مجموعه دادهها با دو هدف انجام میشود:
- افزایش کارایی و سرعت روشهای دستهبندی با کاهش ابعاد و اندازه دادهها: بخصوص جهت بکارگیری برخی روشهای دستهبندی که فاز آموزش آنها هزینه و سربار زمانی یا حافظهای بالایی دارند (مانند SVM)، این امر ضروری است.
- افزایش دقت روشهای دستهبندی: با حذف ویژگیهای نویزی (که وجود آنها باعث افزایش خطای دستهبندی برای دادههای جدید میشوند) و استخراج ویژگیهای مناسب (که باعث نزدیک شدن دادههای درون دستهها و تمایز بیشتر بین دادههای دستههای مختلف میشوند).
امروزه هدف سومی نیز اهمیت زیادی پیدا کرده است: بازنمایی معنا. در روشهای نوین، بردار هر متن طوری ساخته میشود که متنهای هممعنا (حتی با کلمات کاملاً متفاوت) بردارهای نزدیک به هم داشته باشند. همین ویژگی پایه موتورهای جستجوی معنایی، سامانههای پرسش و پاسخ و تولید پاسخ با کمک بازیابی (RAG) در مدلهای زبانی بزرگ است.
رویکردهای مختلف بازنمایی برداری متون
به فرایند تبدیل متن به اعداد، بردارسازی (vectorization) یا بازنمایی برداری (vector representation) متون یا مدل فضای برداری (Vector Space Model – VSM) میگویند. خروجی این فرایند برای هر سند (یا کلمه) یک بردار است که میتوان فاصله یا شباهت آن را با بردارهای دیگر سنجید (مثلاً با شباهت کسینوسی).
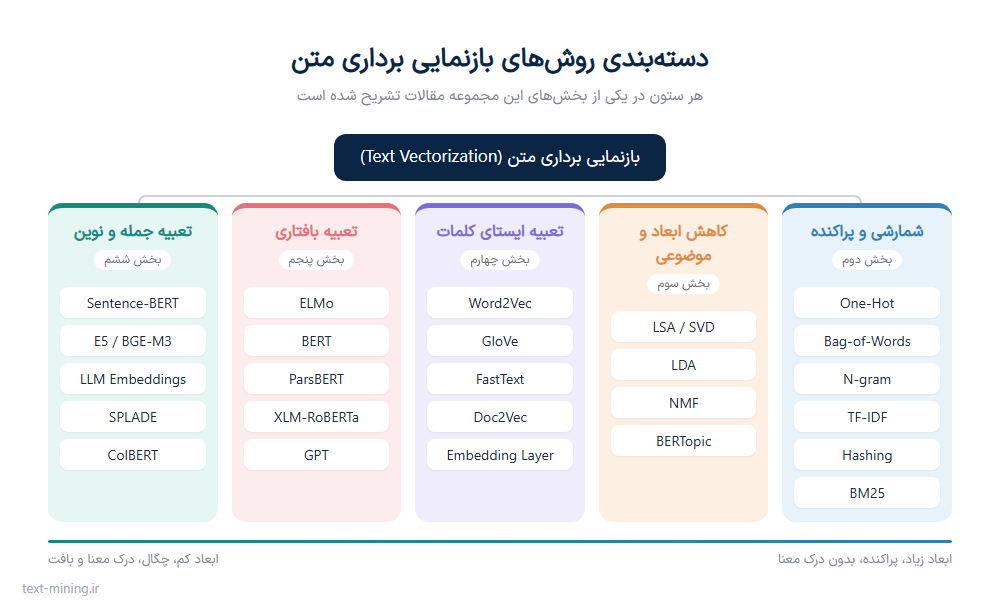
رویکردهای مختلفی برای بردارسازی متون زبان طبیعی وجود دارند که از روشهای ساده شمارشی تا مدلهای زبانی بزرگ را در بر میگیرند:
۱. رویکرد کیف کلمات (Bag-of-Words – BoW) و روشهای شمارشی
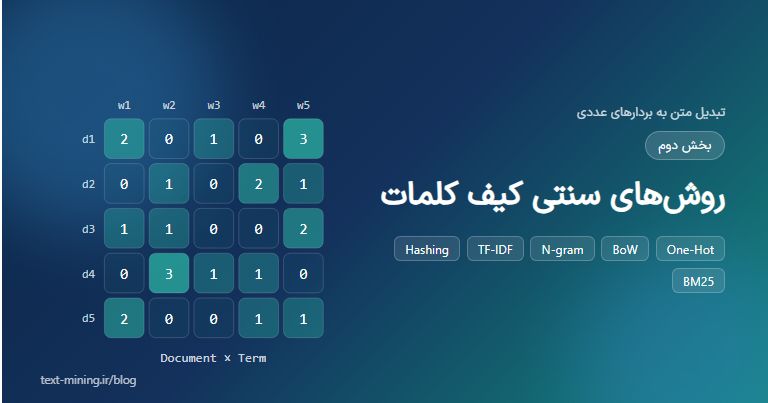
در این روشها هر بُعد بردار متناظر یک واژه (یا عبارت) از واژگان است و مقدار آن بر اساس حضور یا تعداد تکرار واژه تعیین میشود. بردارها بسیار بلند و پراکنده (Sparse) هستند و ترتیب و معنای کلمات در نظر گرفته نمیشود، اما ساده، سریع و قابل تفسیرند (بخش دوم):
- کدگذاری دودویی (Binary) یا وانهات (One-Hot Encoding)
- بردارسازی شمارشی (Frequency/Count Vectorizer) و وزندهی مبتنی بر TF-IDF
- شمارش چندگانهها (Word/Char N-gram)
- بردارسازی درهم (Hashing Vectorizer)
- وزندهی احتمالاتی BM25 (پایه بسیاری از موتورهای جستجو)
۲. کاهش ابعاد و مدلهای موضوعی (Topic Models)
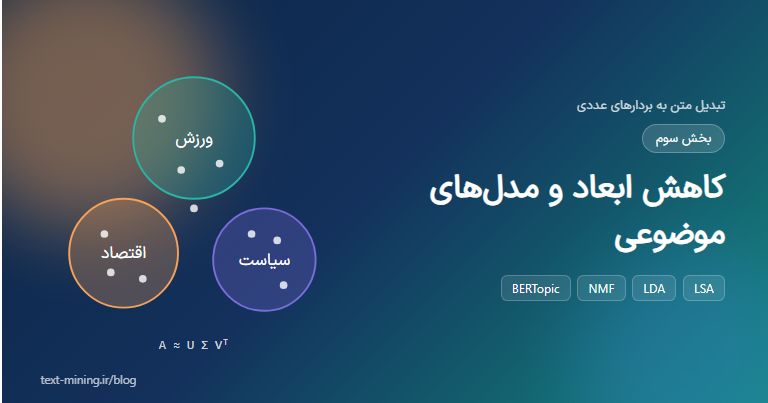
این روشها ماتریس بزرگ و پراکنده سند-واژه را به فضایی با ابعاد کم (معمولاً ۵۰ تا ۵۰۰ بُعد) نگاشت میکنند که هر بُعد آن یک «مفهوم» یا «موضوع» پنهان است (بخش سوم):
- تحلیل معنایی پنهان (LSA/LSI) مبتنی بر تجزیه مقادیر منفرد (SVD)
- تخصیص پنهان دیریکله (LDA)
- تجزیه ماتریس نامنفی (NMF)
- مدلسازی موضوعی مبتنی بر تعبیهها (BERTopic)
۳. بازنمایی توزیعشده و تعبیه ایستای کلمات (Static Word Embeddings)
بر اساس «فرضیه توزیعی» (کلماتی که در بافتهای مشابه به کار میروند معنای مشابهی دارند)، برای هر کلمه یک بردار چگال (Dense) و کمبُعد یاد گرفته میشود. این روشها نقطه آغاز «انتقال یادگیری» (Transfer Learning) در پردازش زبان بودند (بخش چهارم):
- روشهای تعبیه کلمات (Word Embedding) و متن از قبیل: Word2Vec، GloVe، FastText و Doc2Vec
- لایه تعبیه (Embedding Layer) در شبکههای عصبی عمیق
۴. تعبیههای بافتاری (Contextual Embeddings) و مدلهای از پیش آموزشدیده
در این رویکرد، بردار هر کلمه با توجه به جملهای که در آن آمده محاسبه میشود؛ بنابراین کلمه چندمعنایی «شیر» در «شیر جنگل» و «لیوان شیر» دو بردار متفاوت دارد. این مدلها روی حجم عظیمی از متن از پیش آموزش داده شدهاند (بخش پنجم):
- مدلهای مبتنی بر LSTM دوطرفه مانند ELMo
- مدلهای رمزگذار ترنسفورمر (Transformer Encoder) مانند BERT، RoBERTa، DistilBERT، ALBERT، ELECTRA و نسخههای فارسی و چندزبانه مانند ParsBERT و XLM-RoBERTa
- مدلهای رمزگشا (Decoder) و مولد مانند GPT، GPT-2، XLNet و Transformer-XL
۵. تعبیه جملات و اسناد و روشهای نوین
نسل جدید مدلها مستقیماً برای تولید یک بردار باکیفیت برای کل جمله، پاراگراف یا سند آموزش داده میشوند و معمولاً با یادگیری تقابلی (Contrastive Learning) روی میلیونها جفت متن مشابه آموزش میبینند. امروز این مدلها پرکاربردترین روش بردارسازی متن در جستجوی معنایی و RAG هستند (بخش ششم):
- رمزگذارهای جمله مانند Sentence-BERT و Universal Sentence Encoder
- مدلهای تعبیه چندزبانه همهمنظوره مانند E5، BGE-M3 و GTE
- تعبیههای مبتنی بر مدلهای زبانی بزرگ (LLM Embeddings) مانند Qwen3-Embedding و سرویسهای تعبیه OpenAI
- بازنماییهای پراکنده یادگرفتهشده (SPLADE) و چندبرداری (ColBERT)، و بردارهای ماتریوشکا (Matryoshka) با ابعاد قابل کوتاهسازی
سیر تکامل روشها
روشهای بردارسازی متن در طول پنج دهه، از شمارش ساده کلمات در بازیابی اطلاعات به مدلهایی رسیدهاند که معنا و بافت را درک میکنند. شکل زیر نقاط عطف این مسیر را نشان میدهد:
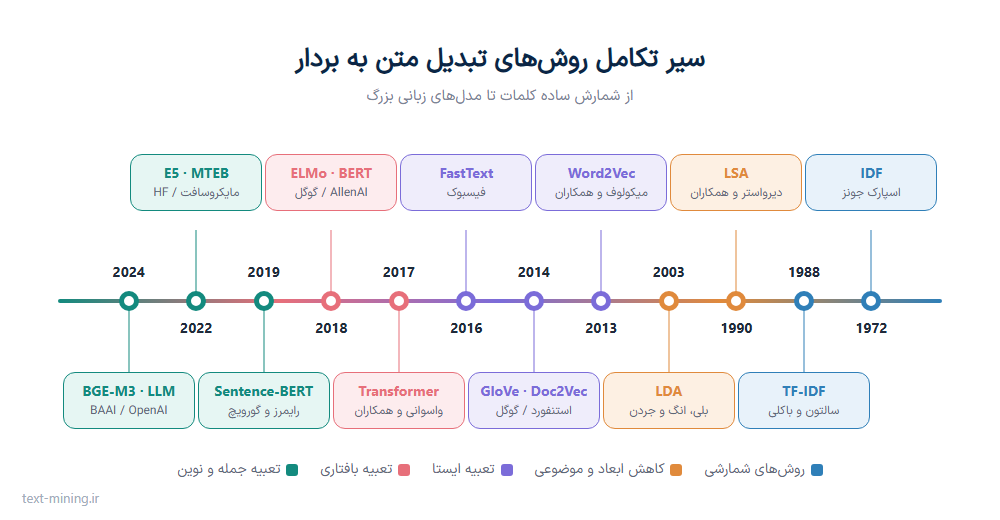
- دهه ۷۰ و ۸۰ میلادی: معرفی وزن معکوس فراوانی سند (IDF) توسط اسپارک جونز و فرمولبندی TF-IDF و مدل فضای برداری توسط سالتون، که هنوز هم پایه موتورهای جستجو هستند.
- دهه ۹۰ و ۲۰۰۰: روشهای جبری و احتمالاتی کاهش ابعاد (LSA و LDA) برای کشف مفاهیم و موضوعات پنهان.
- ۲۰۱۳ تا ۲۰۱۷: انقلاب تعبیه کلمات با Word2Vec، سپس GloVe، Doc2Vec و FastText؛ بردارهای چگال و معنادار که روی پیکرههای بزرگ آموزش میدیدند.
- ۲۰۱۸ به بعد: تعبیههای بافتاری با ELMo و سپس ترنسفورمرها و BERT که بردار هر کلمه را وابسته به جمله تولید میکنند.
- ۲۰۱۹ تا امروز: مدلهای تعبیه جمله (Sentence-BERT، E5، BGE-M3) و تعبیههای مبتنی بر مدلهای زبانی بزرگ که بر اساس محکهایی مانند MTEB ارزیابی و رتبهبندی میشوند.
مقایسه کلی رویکردها
| رویکرد | نوع بردار | ابعاد معمول | درک معنا | درک بافت | هزینه محاسباتی |
|---|---|---|---|---|---|
| کیف کلمات و TF-IDF | پراکنده | ۱۰ هزار تا میلیونها | ندارد | ندارد | بسیار کم |
| LSA / LDA / NMF | چگال | ۵۰ تا ۵۰۰ | نسبی (همرخدادی) | ندارد | کم |
| Word2Vec / FastText | چگال | ۱۰۰ تا ۳۰۰ | دارد | ندارد | کم |
| BERT و ترنسفورمرها | چگال | ۷۶۸ تا ۱۰۲۴ | دارد | دارد | متوسط تا زیاد (ترجیحاً GPU) |
| تعبیه جمله و LLM | چگال (و گاهی پراکنده/چندبرداری) | ۳۸۴ تا ۴۰۹۶ | بسیار خوب | دارد | متوسط تا زیاد |
کدام روش را انتخاب کنیم؟
- داده کم، نیاز به سرعت بالا یا تفسیرپذیری: TF-IDF (با N-gram کلمه یا حرف) به همراه یک دستهبند خطی مانند رگرسیون لجستیک یا SVM، هنوز یک خط مبنای (Baseline) بسیار قوی است.
- جستجوی کلیدواژهای و تطبیق دقیق عبارات: BM25.
- کشف و تحلیل موضوعات یک پیکره بزرگ: LDA یا NMF و در صورت وجود GPU، BERTopic.
- شباهت کلمات، گسترش پرسوجو و منابع محدود: FastText (بهخاطر پشتیبانی از کلمات خارج از واژگان و ریختشناسی غنی زبان فارسی).
- دستهبندی، تشخیص موجودیتها و تحلیل احساسات با بالاترین دقت: تنظیم دقیق (Fine-tuning) مدلهای ترنسفورمری مانند ParsBERT یا XLM-RoBERTa.
- جستجوی معنایی، خوشهبندی، پیشنهاد محتوا و RAG: مدلهای تعبیه جمله چندزبانه مانند multilingual-E5 یا BGE-M3 و در صورت نیاز ترکیب آن با BM25 (جستجوی ترکیبی).
جایگاه پیشپردازش در بازنمایی برداری متن
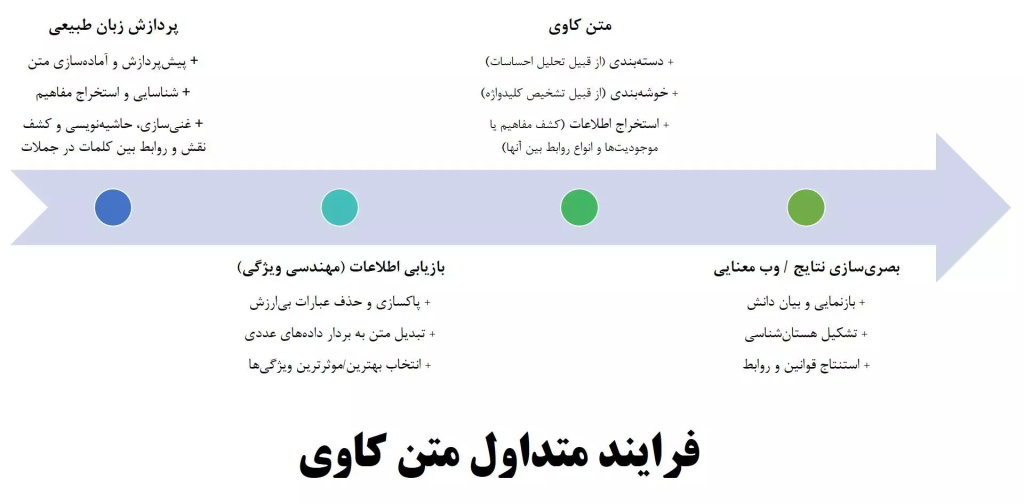
یکی از مراحل مهم در فرایند متنکاوی پیشپردازش متن است. اغلب پیشپردازش متن در ابتدای فرایند متن کاوی و با یکی از اهداف ذیل انجام میشود:
- پاکسازی و استانداردسازی متن از قبیل: اصلاح نویسهها، فاصله و نیمفاصلهها، وندها یا کلمات مرکب جدانوشته شده، تبدیل کلمات محاورهای و کاراکترهای حسی (ایموجی) به شکل استاندارد، ریشهیابی و …
- غنیسازی یا حاشیهنویسی متن (افزودن اطلاعات جانبی مفید به متن) از قبیل: برچسبزنی نقش ادات سخن، گسترش معنایی کلمات (افزودن کلمات هممعنی یا همکاربرد با کلمات کلیدی داخل متن) و …
- حذف ویژگیهای اضافه (کلمات بدون ارزش) از قبیل: حذف کلمات توقف، انتخاب کلیدواژهها یا موجودیتهای نامی و حذف سایر کلمات و …
توجه داشته باشید که اهمیت پیشپردازش در روشهای مختلف یکسان نیست. در روشهای شمارشی (مانند TF-IDF) یکسانسازی نویسهها، اصلاح نیمفاصله، حذف کلمات توقف و ریشهیابی تأثیر زیادی بر کیفیت دارند؛ چرا که «میروم» و «می روم» دو ویژگی کاملاً جدا محسوب میشوند. اما در مدلهای ترنسفورمری، معمولاً فقط نرمالسازی نویسهها کافی است و حذف کلمات توقف یا ریشهیابی ممکن است حتی به کیفیت آسیب بزند؛ زیرا این مدلها از ساختار کامل جمله برای درک معنا استفاده میکنند.
برای نمونه، با کتابخانه هضم میتوان متن فارسی را پیش از بردارسازی نرمالسازی و توکنبندی کرد:
pip install hazmfrom hazm import Normalizer, word_tokenize
normalizer = Normalizer()
text = normalizer.normalize("متن كاوي فارسي ميتواند خيلي جذاب باشد")
print(text)
print(word_tokenize(text))پیشنهاد میکنیم، برای اطلاع بیشتر درباره فرایند متن کاوی به این مقاله و برای آشنایی با ابزارهای پردازش متن به این مقاله مراجعه بفرمایید. همچنین ابزارهای نرمالسازی، توکنبندی، ریشهیابی و … زبان فارسی بصورت سرویس API متن کاوی فارسییار نیز در دسترس هستند.
ادامه این مجموعه
در بخشهای بعدی این مجموعه، هر دسته از روشها را همراه با شکلها، مثالهای فارسی و کد پایتون تشریح میکنیم:
- بخش دوم: روشهای سنتی کیف کلمات (One-Hot، BoW، N-gram، TF-IDF، Hashing و BM25)
- بخش سوم: کاهش ابعاد و مدلهای موضوعی (LSA، LDA، NMF و BERTopic)
- بخش چهارم: تعبیه ایستای کلمات (Word2Vec، GloVe، FastText و Doc2Vec)
- بخش پنجم: تعبیههای بافتاری و ترنسفورمرها (ELMo، BERT، ParsBERT و GPT)
- بخش ششم: تعبیه جملات و روشهای نوین (Sentence-BERT، E5، BGE-M3 و تعبیههای LLM)
منابع
- Salton, G., Wong, A., & Yang, C. S. (1975). A vector space model for automatic indexing. Communications of the ACM, 18(11). doi:10.1145/361219.361220
- Manning, C. D., Raghavan, P., & Schütze, H. (2008). Introduction to Information Retrieval. Cambridge University Press. nlp.stanford.edu/IR-book
- Guyon, I., & Elisseeff, A. (2003). An Introduction to Variable and Feature Selection. Journal of Machine Learning Research, 3. jmlr.org
- Mikolov, T., et al. (2013). Efficient Estimation of Word Representations in Vector Space. arXiv:1301.3781
- Devlin, J., et al. (2019). BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding. NAACL. arXiv:1810.04805
- Reimers, N., & Gurevych, I. (2019). Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks. EMNLP. arXiv:1908.10084
- Muennighoff, N., et al. (2023). MTEB: Massive Text Embedding Benchmark. EACL. arXiv:2210.07316
- مستندات کتابخانه هضم برای پردازش زبان فارسی: github.com/roshan-research/hazm
استفاده از این مقاله با ذکر منبع «سامانه متن کاوی فارسییار – text-mining.ir»، بلامانع است.