در بخش پنجم دیدیم که مدلهایی مانند BERT بردارهای بافتاری فوقالعادهای برای کلمات تولید میکنند، اما بردار خام آنها برای سنجش مستقیم شباهت معنایی دو جمله مناسب نیست. در این بخش پایانی، نسل جدید مدلهایی را بررسی میکنیم که مستقیماً برای تولید یک بردار باکیفیت برای کل جمله، پاراگراف یا سند آموزش دیدهاند. این مدلها امروز موتور اصلی جستجوی معنایی، خوشهبندی، سامانههای پیشنهاددهنده و تولید پاسخ با کمک بازیابی (RAG) در کنار مدلهای زبانی بزرگ هستند.
۱. Sentence-BERT و رمزگذار دوگانه
فرض کنید میخواهیم در میان ۱۰ هزار جمله، شبیهترین جفت را پیدا کنیم. با یک رمزگذار متقاطع (Cross-Encoder) که هر دو جمله را با هم به BERT میدهد، باید حدود ۵۰ میلیون بار مدل را اجرا کنیم (حدود ۶۵ ساعت). Sentence-BERT (SBERT) که در سال ۲۰۱۹ معرفی شد، این مشکل را با معماری رمزگذار دوگانه (Bi-Encoder) یا سیامی حل کرد: هر جمله جداگانه و یک بار به بردار تبدیل میشود و شباهت با یک ضرب داخلی ساده محاسبه میشود؛ همان کار در چند ثانیه انجام میشود.
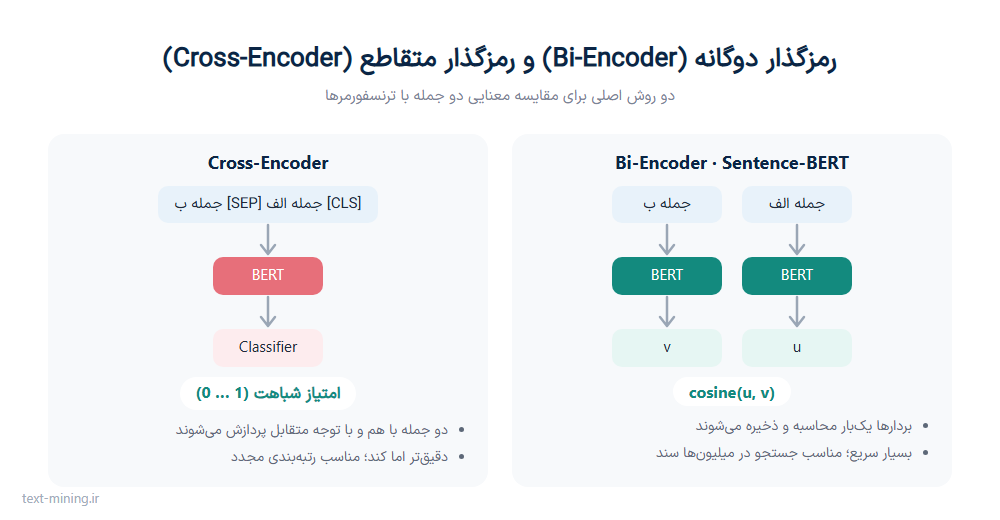
کلید موفقیت SBERT، آموزش شبکه روی جفت جملات (مثلاً دادههای استنتاج زبان طبیعی یا جفت پرسشهای هممعنا) است تا بردار جملات هممعنا به هم نزدیک و جملات نامرتبط از هم دور شوند. کتابخانه sentence-transformers این مدلها و صدها مدل دیگر را با رابطی ساده در اختیار قرار میدهد:
pip install -U sentence-transformers faiss-cpu FlagEmbedding openaifrom sentence_transformers import SentenceTransformer
model = SentenceTransformer("sentence-transformers/paraphrase-multilingual-mpnet-base-v2")
sentences = [
"هوا امروز آفتابی است",
"امروز آسمان صاف و بدون ابر است",
"قیمت دلار در بازار افزایش یافت",
]
embeddings = model.encode(sentences, normalize_embeddings=True)
print(embeddings.shape) # (3, 768)
print(model.similarity(embeddings, embeddings)) # ماتریس شباهت کسینوسی 3 × 3در خروجی، شباهت دو جمله اول (با وجود کلمات کاملاً متفاوت) بسیار بیشتر از شباهت آنها با جمله سوم خواهد بود. مدلهای چندزبانه sentence-transformers با روش «تقطیر دانش چندزبانه» آموزش دیدهاند؛ بنابراین جمله فارسی و ترجمه انگلیسی آن نیز بردارهای نزدیکی دارند و جستجوی بینزبانی ممکن میشود.
۲. یادگیری تقابلی و مدلهای تعبیه همهمنظوره
نسل بعدی مدلهای تعبیه با یادگیری تقابلی (Contrastive Learning) در مقیاس بسیار بزرگ آموزش میبینند: ابتدا روی صدها میلیون جفت متن مرتبط که از وب جمعآوری شده (عنوان و متن مقاله، پرسش و پاسخ، نقلقول و منبع) و سپس روی دادههای برچسبدار باکیفیت. در هر گام، مدل یاد میگیرد بردار هر پرسش را به بردار سند مرتبطش نزدیک و از بردار سایر اسناد دسته (In-batch negatives) دور کند. برخی از مطرحترین مدلهای متنباز با پشتیبانی خوب از زبان فارسی:
- multilingual-E5: خانواده مدلهای مایکروسافت در سه اندازه small، base و large. نکته مهم: متن پرسش باید با پیشوند
query:و متن اسناد با پیشوندpassage:رمزگذاری شود. - BGE-M3: مدل مؤسسه BAAI که «چندکاره» است: همزمان بردار چگال، وزنهای پراکنده واژگانی (مشابه BM25 یادگرفتهشده) و بردارهای چندگانه (مشابه ColBERT) تولید میکند، از بیش از ۱۰۰ زبان پشتیبانی میکند و متنهای تا ۸۱۹۲ توکن را میپذیرد.
- GTE، Jina Embeddings و Nomic Embed: سایر خانوادههای پرکاربرد مدلهای تعبیه متنباز.
from sentence_transformers import SentenceTransformer
e5 = SentenceTransformer("intfloat/multilingual-e5-base")
query = ["query: مالیات بر ارزش افزوده چیست؟"]
passages = [
"passage: مالیات بر ارزش افزوده نوعی مالیات غیرمستقیم است که بر مصرف کالا و خدمات وضع میشود.",
"passage: تیم ملی فوتبال ایران در جام جهانی شرکت کرد.",
"passage: اظهارنامه مالیاتی باید تا پایان خرداد ارسال شود.",
]
q = e5.encode(query, normalize_embeddings=True)
p = e5.encode(passages, normalize_embeddings=True)
print(q @ p.T) # امتیاز شباهت پرسش با هر سنداستفاده از BGE-M3 و هر سه نوع خروجی آن با کتابخانه FlagEmbedding:
from FlagEmbedding import BGEM3FlagModel
bge = BGEM3FlagModel("BAAI/bge-m3", use_fp16=True) # fp16 روی GPU سریعتر است
output = bge.encode(
["متن کاوی فارسی جذاب است", "پردازش زبان طبیعی شاخهای از هوش مصنوعی است"],
return_dense=True, return_sparse=True, return_colbert_vecs=True,
)
print(output["dense_vecs"].shape) # (2, 1024) بردار چگال
print(output["lexical_weights"][0]) # وزن پراکنده هر توکن
print(output["colbert_vecs"][0].shape) # یک بردار برای هر توکن۳. تعبیههای مبتنی بر مدلهای زبانی بزرگ (LLM Embeddings)
از سال ۲۰۲۳، پژوهشگران نشان دادند که با آموزش تقابلی روی مدلهای زبانی بزرگ رمزگشا (مانند Mistral یا Qwen) میتوان به بهترین نتایج در محکهای تعبیه رسید. این مدلها دانش زبانی و جهانی بسیار گستردهتری دارند، از متون طولانی پشتیبانی میکنند و اغلب با یک «دستورالعمل» (Instruction) هدف تعبیه را دریافت میکنند؛ مثلاً «برای پرسش زیر، اسناد مرتبط را بازیابی کن». نمونهها: Qwen3-Embedding، e5-mistral-7b-instruct، NV-Embed و gte-Qwen2. هزینه این دقت بیشتر، ابعاد بالاتر بردار (معمولاً ۱۰۲۴ تا ۴۰۹۶) و نیاز به GPU قویتر است.
from sentence_transformers import SentenceTransformer
qwen = SentenceTransformer("Qwen/Qwen3-Embedding-0.6B")
queries = ["پایتخت ایران کجاست؟"]
documents = ["تهران پایتخت و بزرگترین شهر ایران است.", "اصفهان به نصف جهان مشهور است."]
q = qwen.encode(queries, prompt_name="query") # افزودن دستورالعمل پرسش
d = qwen.encode(documents)
print(qwen.similarity(q, d))سرویسهای تجاری نیز رابط برنامهنویسی (API) تعبیه ارائه میدهند. برای مثال مدلهای تعبیه OpenAI امکان کوتاه کردن ابعاد بردار را با پارامتر dimensions فراهم میکنند (توجه داشته باشید که ارسال داده به سرویسهای خارجی ممکن است با الزامات حریم خصوصی سازمان شما سازگار نباشد):
from openai import OpenAI
client = OpenAI() # کلید API از متغیر محیطی OPENAI_API_KEY خوانده میشود
response = client.embeddings.create(
model="text-embedding-3-small",
input=["متن کاوی فارسی جذاب است", "پردازش زبان طبیعی"],
dimensions=512,
)
vectors = [item.embedding for item in response.data]
print(len(vectors), len(vectors[0])) # 2 512۴. بازنماییهای پراکنده یادگرفتهشده و چندبرداری
- SPLADE: با استفاده از سر مدل زبانی نقابدار BERT، برای هر سند یک بردار پراکنده به طول واژگان تولید میکند که علاوه بر کلمات خود سند، کلمات مرتبط (گسترش معنایی) را نیز با وزن مناسب در بر دارد. این بردارها مانند BM25 در نمایه معکوس (Inverted Index) قابل جستجو هستند اما درک معنایی دارند.
- ColBERT (تعامل تأخیری): بهجای فشرده کردن سند در یک بردار، برای هر توکن یک بردار کوچک نگه میدارد و امتیاز شباهت را از جمع بیشینه شباهت هر توکن پرسش با توکنهای سند (MaxSim) محاسبه میکند. دقت آن به رمزگذار متقاطع نزدیک و سرعتش به رمزگذار دوگانه نزدیک است، اما فضای ذخیرهسازی بیشتری میخواهد.
- بردارهای ماتریوشکا (Matryoshka): مدل طوری آموزش میبیند که چند ده بُعد اول بردار بهتنهایی نیز بازنمایی خوبی باشند. بنابراین میتوان بردار ۱۰۲۴ بُعدی را به ۲۵۶ یا ۱۲۸ بُعد کوتاه کرد و با افت دقت اندک، حافظه و زمان جستجو را چند برابر کاهش داد. در sentence-transformers کافی است پارامتر
truncate_dimرا تنظیم کنید. - کوانتیزهسازی (Quantization): ذخیره بردارها بهصورت int8 یا حتی دودویی (Binary) حجم را تا ۳۲ برابر کاهش میدهد و در پایگاههای برداری مدرن پشتیبانی میشود.
۵. کاربرد عملی: جستجوی معنایی و RAG
رایجترین کاربرد مدلهای تعبیه، جستجوی معنایی است: اسناد یکبار به بردار تبدیل و در یک نمایه برداری ذخیره میشوند و در زمان جستجو، پرسش کاربر با همان مدل به بردار تبدیل و نزدیکترین بردارها بازیابی میشوند. در معماری RAG (Retrieval-Augmented Generation)، اسناد بازیابیشده بهعنوان زمینه به یک مدل زبانی بزرگ داده میشوند تا پاسخی دقیق و مستند تولید کند.
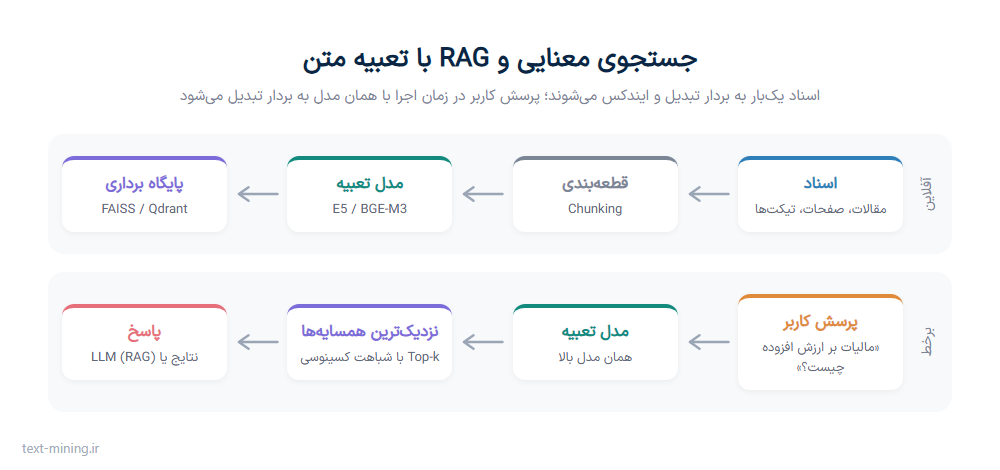
نمونه یک جستجوی معنایی کامل با کتابخانه FAISS برای جستجوی سریع در میلیونها بردار:
import faiss
from sentence_transformers import SentenceTransformer
model = SentenceTransformer("intfloat/multilingual-e5-base")
# corpus: لیست اسناد یا قطعههای متنی (مثلاً پاراگرافهای مقالات)
corpus_emb = model.encode(["passage: " + doc for doc in corpus],
normalize_embeddings=True, batch_size=64, show_progress_bar=True)
index = faiss.IndexFlatIP(corpus_emb.shape[1]) # ضرب داخلی = شباهت کسینوسی برای بردارهای نرمال
index.add(corpus_emb)
faiss.write_index(index, "corpus.index") # ذخیره نمایه برای استفادههای بعدی
query_emb = model.encode(["query: روشهای تبدیل متن به بردار"], normalize_embeddings=True)
scores, ids = index.search(query_emb, 5)
for score, i in zip(scores[0], ids[0]):
print(f"{score:.3f} {corpus[i][:80]}")برای افزایش دقت، معمولاً یک مرحله رتبهبندی مجدد (Reranking) با رمزگذار متقاطع روی چند ده نتیجه اول اضافه میشود:
from sentence_transformers import CrossEncoder
reranker = CrossEncoder("BAAI/bge-reranker-v2-m3")
query = "روشهای تبدیل متن به بردار"
candidates = [corpus[i] for i in ids[0]]
scores = reranker.predict([(query, doc) for doc in candidates])
reranked = sorted(zip(scores, candidates), reverse=True)نکات مهم در پیادهسازی جستجوی معنایی:
- قطعهبندی (Chunking): اسناد طولانی را به قطعههای ۲۰۰ تا ۵۰۰ کلمهای (با کمی همپوشانی) تقسیم کنید؛ بردار یک سند دهصفحهای جزئیات را از دست میدهد.
- جستجوی ترکیبی (Hybrid): ترکیب امتیاز BM25 با امتیاز معنایی، در بازیابی نامهای خاص، کدها و اصطلاحات تخصصی بسیار مؤثر است.
- پایگاههای داده برداری: برای مقیاس بزرگ و امکاناتی مانند فیلتر و بهروزرسانی، از ابزارهایی مانند Qdrant، Milvus، Weaviate، Elasticsearch یا افزونه pgvector در PostgreSQL استفاده کنید.
- یکسان بودن مدل: اسناد و پرسشها باید با یک مدل (و پیشوندهای مخصوص آن) رمزگذاری شوند؛ با تغییر مدل، کل نمایه باید دوباره ساخته شود.
۶. ارزیابی و انتخاب مدل تعبیه
محک MTEB (Massive Text Embedding Benchmark) مدلهای تعبیه را روی دهها وظیفه مختلف (بازیابی، دستهبندی، خوشهبندی، شباهت معنایی و …) و در زبانهای متعدد ارزیابی میکند و جدول رتبهبندی آن در Hugging Face مرجع اصلی مقایسه مدلهاست. با این حال بهترین راه انتخاب، ارزیابی چند مدل روی نمونهای از داده و پرسشهای واقعی خودتان است. جدول زیر یک راهنمای کلی ارائه میدهد:
| نیاز | گزینه پیشنهادی | ملاحظات |
|---|---|---|
| منابع محدود، CPU، سرعت بالا | multilingual-e5-small یا paraphrase-multilingual-MiniLM-L12-v2 | ۳۸۴ بُعد، سبک و سریع |
| تعادل دقت و هزینه برای فارسی | multilingual-e5-base یا BAAI/bge-m3 | ۷۶۸ / ۱۰۲۴ بُعد؛ BGE-M3 برای متون بلند |
| بیشترین دقت با GPU | مدلهای مبتنی بر LLM مانند Qwen3-Embedding | ابعاد و هزینه بیشتر؛ با ماتریوشکا قابل کوتاهسازی |
| بدون زیرساخت محلی | API تعبیه سرویسهای ابری | هزینه به ازای توکن و ملاحظات حریم خصوصی |
| دقت بالاتر در رتبههای اول | افزودن رمزگذار متقاطع (Reranker) | فقط روی چند ده نتیجه اول اجرا شود |
جمعبندی مجموعه
در این مجموعه ششقسمتی، مسیر تکامل روشهای تبدیل متن به بردارهای عددی را از شمارش ساده کلمات و TF-IDF، به مدلهای موضوعی و کاهش ابعاد، تعبیه ایستای کلمات، تعبیههای بافتاری ترنسفورمری و در نهایت مدلهای تعبیه جمله و LLM دنبال کردیم. با وجود قدرت چشمگیر روشهای جدید، روشهای قدیمیتر هنوز جایگاه خود را دارند: TF-IDF و BM25 سریع، ارزان و تفسیرپذیرند و در بسیاری از سامانههای واقعی در کنار تعبیههای معنایی استفاده میشوند. انتخاب درست، به داده، منابع محاسباتی و نیاز مسئله شما بستگی دارد.
منابع
- Reimers, N., & Gurevych, I. (2019). Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks. EMNLP. arXiv:1908.10084
- Reimers, N., & Gurevych, I. (2020). Making Monolingual Sentence Embeddings Multilingual using Knowledge Distillation. EMNLP. arXiv:2004.09813
- Cer, D., et al. (2018). Universal Sentence Encoder. arXiv:1803.11175
- Wang, L., et al. (2022). Text Embeddings by Weakly-Supervised Contrastive Pre-training (E5). arXiv:2212.03533
- Wang, L., et al. (2024). Multilingual E5 Text Embeddings: A Technical Report. arXiv:2402.05672
- Chen, J., et al. (2024). BGE M3-Embedding: Multi-Lingual, Multi-Functionality, Multi-Granularity Text Embeddings Through Self-Knowledge Distillation. arXiv:2402.03216
- Zhang, Y., et al. (2025). Qwen3 Embedding: Advancing Text Embedding and Reranking Through Foundation Models. arXiv:2506.05176
- Khattab, O., & Zaharia, M. (2020). ColBERT: Efficient and Effective Passage Search via Contextualized Late Interaction over BERT. SIGIR. arXiv:2004.12832
- Formal, T., Piwowarski, B., & Clinchant, S. (2021). SPLADE: Sparse Lexical and Expansion Model for First Stage Ranking. SIGIR. arXiv:2107.05720
- Kusupati, A., et al. (2022). Matryoshka Representation Learning. NeurIPS. arXiv:2205.13147
- Muennighoff, N., Tazi, N., Magne, L., & Reimers, N. (2023). MTEB: Massive Text Embedding Benchmark. EACL. arXiv:2210.07316
- Johnson, J., Douze, M., & Jégou, H. (2019). Billion-scale similarity search with GPUs (FAISS). arXiv:1702.08734
- Lewis, P., et al. (2020). Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. NeurIPS. arXiv:2005.11401
- مستندات sentence-transformers: sbert.net و جدول رتبهبندی MTEB: huggingface.co/spaces/mteb/leaderboard
استفاده از این مقاله با ذکر منبع «سامانه متن کاوی فارسییار – text-mining.ir»، بلامانع است.